---
title: "El Modelo de Regresión Lineal Simple"
---
## Objetivos de aprendizaje {.unnumbered}
Al terminar este capítulo, el lector debería ser capaz de:
- Escribir la Función de Regresión Poblacional (FRP) y la Función de Regresión Muestral (FRM) del modelo lineal simple y explicar qué representa cada una.
- Derivar los estimadores MCO $\hat\beta_0$ y $\hat\beta_1$ como minimizadores de la suma de cuadrados de los residuos.
- Enunciar los cinco supuestos de Gauss--Markov para la Regresión Lineal Simple (RLS) y explicar qué garantiza cada uno.
- Seguir la demostración de la insesgadez de MCO e identificar qué supuesto se usa en cada paso.
- Escribir la varianza muestral de $\hat\beta_1$, nombrar los tres factores que determinan su precisión y explicar el significado de ELIO (BLUE en inglés).
- Descomponer la variación total en $\mathrm{SCT} = \mathrm{SCE} + \mathrm{SCR}$ y calcular e interpretar el $R^2$.
- Utilizar `lm()` en R para estimar, interpretar y visualizar una regresión simple sobre los conjuntos de datos `beauty` y `bwght`.
## Pregunta empírica motivadora {.unnumbered}
> *¿Cuánto más alto es el salario, en media, de un trabajador valorado «por encima de la media» en apariencia física, frente a uno valorado «en la media»?*
La literatura de economía laboral [@wooldridge2020] documenta desde hace décadas una *prima por apariencia* (*beauty premium*): los trabajadores percibidos como más atractivos físicamente tienden a ganar salarios más altos. Si esa prima es causal (la apariencia abre puertas) o si refleja otros factores correlacionados con ella (salud, habilidades sociales, origen familiar) es una pregunta distinta. Pero antes de poder *plantearla* necesitamos una herramienta que convierta una nube de puntos en un único número. Esa herramienta es la **regresión lineal simple** del salario sobre una medida de apariencia. En §2.11 se estima exactamente esta regresión sobre el conjunto de datos `beauty` de Hamermesh.
## Introducción
`\lettrine[lines=3]{E}{l}`{=latex} análisis de regresión investiga la relación entre dos o más variables. En este capítulo nos centramos en el modelo de **Regresión Lineal Simple** (RLS), que relaciona una variable dependiente $y$ con una única variable independiente $x$:
$$
y = \beta_0 + \beta_1 x + u.
$$
Aquí $y$ es la variable dependiente, $x$ es la variable independiente (también llamada regresor o variable explicativa), $\beta_0$ es el **intercepto** (o constante), $\beta_1$ es la **pendiente**, y $u$ es el **término de error** o *perturbación* no observable, que recoge todos los determinantes de $y$ distintos de $x$ [@wooldridge2020]. El parámetro de pendiente $\beta_1$ mide el cambio en $y$ asociado a un cambio de una unidad en $x$, *manteniendo constantes todos los factores en $u$*:
$$
\beta_1 = \frac{\Delta y}{\Delta x} \quad \text{cuando } \Delta u = 0.
$$
El intercepto $\beta_0$ es el valor de $y$ cuando $x = 0$. En muchas aplicaciones $x = 0$ cae fuera del rango de los datos (cero años de educación, cero metros cuadrados, cero cigarrillos diarios para un no fumador) y el intercepto carece de interpretación económica inmediata; aun así es imprescindible para situar la recta en el lugar correcto.
::: {.callout-note}
## Un pequeño catálogo de ejemplos de RLS
Cada uno de los siguientes es una regresión lineal simple de una variable de resultado sobre un único regresor. Volveremos a varios de ellos a lo largo del capítulo.
- Salario sobre años de educación: $\widehat{\text{Salario}} = 800 + 15\cdot\text{Educ}$. Cada año adicional de escolarización se asocia, en media, con 15\ €/mes más.
- Precio de la vivienda sobre superficie: $\widehat{\text{Precio}} = 100{,}000 + 50\cdot\text{m}^2$.
- Valor de reventa de un coche sobre antigüedad: $\widehat{\text{Reventa}} = 30{,}000 - 1{,}500\cdot\text{Años}$.
- Ventas sobre gasto en publicidad: $\widehat{\text{Ventas}} = 50 + 2\cdot\text{Publi}$.
- Presión arterial sobre edad: $\widehat{\text{PA}} = 100 + 0{,}5\cdot\text{Edad}$.
:::
## La Función de Regresión Poblacional
El modelo $y = \beta_0 + \beta_1 x + u$ contiene la perturbación no observable $u$. Para convertirlo en un enunciado contrastable se impone un supuesto clave sobre la media condicional del error:
$$
\mathbb{E}[u \mid x] = 0.
$$
Esto significa que, sean cuales sean los determinantes de $y$ recogidos en $u$, no guardan relación *en media* con $x$. Tomando esperanzas condicionales a ambos lados del modelo y aplicando este supuesto se obtiene la **Función de Regresión Poblacional (FRP)**:
$$
\mathbb{E}[y \mid x] = \beta_0 + \beta_1 x.
$$
La FRP describe el valor *medio* de $y$ para cada valor de $x$ en la población. Es una recta de intercepto $\beta_0$ y pendiente $\beta_1$.
::: {.callout-note}
## La regresión es una comparación
Léase $\beta_1$ como una *comparación entre subpoblaciones*. Si se compara el grupo de individuos con $x = a$ frente al grupo con $x = a + 1$, este último presenta un valor de $y$ que en media es $\beta_1$ unidades superior. Que esa comparación refleje un efecto causal depende de si se cumple $\mathbb{E}[u \mid x] = 0$ --- una cuestión a la que volvemos a lo largo del libro.
:::
El problema fundamental de la FRP es que **no se puede observar**: es un enunciado sobre toda la población, que nunca vemos. Lo mejor que podemos hacer es tomar una muestra y estimar la recta que, a la vista de la evidencia disponible, más se aproxima a la verdadera.
::: {.callout-warning}
## Error frecuente: confundir la FRP con la FRM
La FRP $\mathbb{E}[y \mid x] = \beta_0 + \beta_1 x$ es una propiedad de la *población*: $\beta_0$ y $\beta_1$ son fijos pero desconocidos. La FRM $\hat y = \hat\beta_0 + \hat\beta_1 x$ (sección siguiente) es una recta *aleatoria* cuyo intercepto y pendiente varían de una muestra a otra. Confundir ambas es el error conceptual más frecuente del curso.
:::
## La Función de Regresión Muestral
Sea $\{(x_i, y_i) : i = 1, 2, \ldots, n\}$ una muestra aleatoria de tamaño $n$ extraída de la población. Para cada observación $i$ el modelo poblacional es
$$
y_i = \beta_0 + \beta_1 x_i + u_i.
$$
Se define la **Función de Regresión Muestral (FRM)** como
$$
\hat y_i = \hat\beta_0 + \hat\beta_1 x_i,
$$
donde $\hat\beta_0$ y $\hat\beta_1$ son **estimaciones** de los parámetros poblacionales $\beta_0$ y $\beta_1$ obtenidas a partir de los datos. Los acentos circunflejos recuerdan en todo momento que se trata de cantidades muestrales. Dos muestras distintas de la misma población darán, en general, dos FRM distintas.
## Mínimos Cuadrados Ordinarios (MCO)
Dado un diagrama de dispersión de pares $(x_i, y_i)$, podrían trazarse infinitas rectas a través de la nube de puntos, cada una con un $(\hat\beta_0, \hat\beta_1)$ distinto. ¿Cómo elegir la «mejor» recta?
### Por qué necesitamos un criterio {.unnumbered}
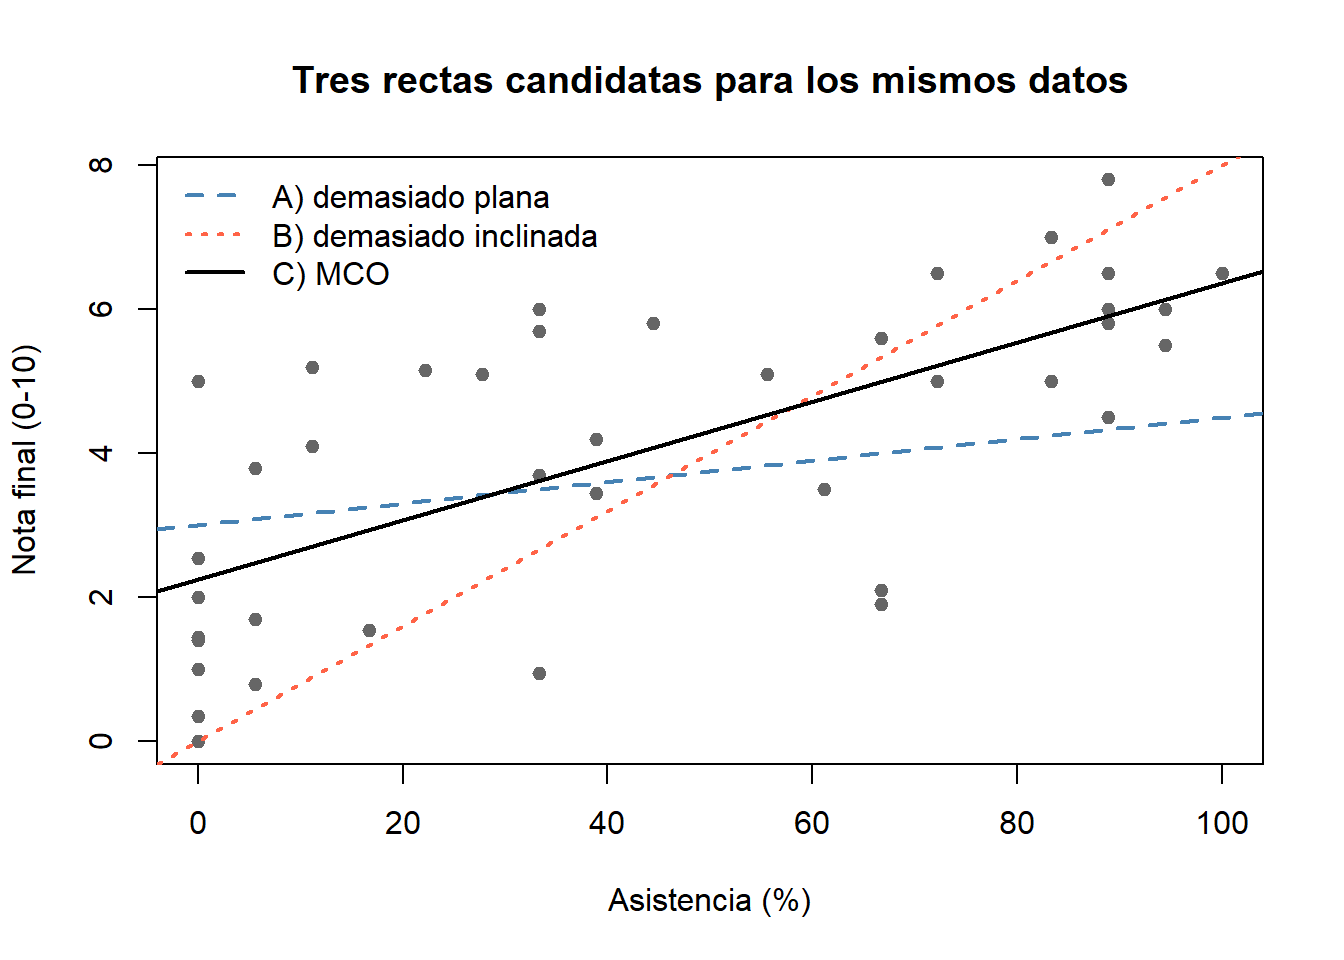
A continuación se muestra un diagrama de dispersión de 41 estudiantes de una promoción reciente de Econometría I en la UGR, en el que se representa la asistencia frente a la nota final. Muchas rectas parecen ajustar «más o menos» bien la nube de puntos; la pregunta es cuál elegir y por qué. Antes de derivar ninguna fórmula conviene *ver* el problema.
```{r slr-ols-criterion-fig}
# 41 estudiantes, Econometría I UGR, curso 2024-25
asistencia <- c(38.89, 94.44, 94.44, 33.33, 83.33, 0, 0, 66.67, 88.89,
                66.67, 27.78, 83.33, 0, 61.11, 0, 22.22, 0, 0, 72.22,
                88.89, 88.89, 11.11, 5.56, 33.33, 16.67, 0, 11.11,
                33.33, 100, 38.89, 5.56, 72.22, 44.44, 0, 55.56, 33.33,
                0, 66.67, 5.56, 88.89, 88.89)
nota       <- c(3.45, 5.5, 6, 3.7, 7, 2.55, 5, 2.1, 5.8, 1.9, 5.1, 5,
                2, 3.5, 2, 5.15, 0.35, 1.45, 5, 4.5, 7.8, 5.2, 3.8, 6,
                1.55, 1, 4.1, 5.7, 6.5, 4.2, 0.8, 6.5, 5.8, 0, 5.1,
                0.95, 1.4, 5.6, 1.7, 6.5, 6)

# Tres rectas candidatas (calcularemos sus SCR)
candidates <- data.frame(
  label = c("A) demasiado plana", "B) demasiado inclinada", "C) MCO"),
  b0    = c(3.0, 0.0, 2.256),
  b1    = c(0.015, 0.08, 0.0411)
)

# Diagrama de dispersión + las tres rectas candidatas
plot(asistencia, nota,
     xlab = "Asistencia (%)", ylab = "Nota final (0-10)",
     pch = 19, col = "grey40", cex = 0.9,
     main = "Tres rectas candidatas para los mismos datos")
cols <- c("steelblue", "tomato", "black")
ltys <- c(2, 3, 1)
for (k in seq_len(nrow(candidates))) {
  abline(a = candidates$b0[k], b = candidates$b1[k],
         col = cols[k], lwd = 2, lty = ltys[k])
}
legend("topleft", legend = candidates$label,
       col = cols, lty = ltys, lwd = 2, bty = "n")
# SCR de cada candidata
ssr <- sapply(seq_len(nrow(candidates)), function(k) {
  yhat <- candidates$b0[k] + candidates$b1[k] * asistencia
  sum((nota - yhat)^2)
})
data.frame(recta = candidates$label,
           beta0 = candidates$b0,
           beta1 = candidates$b1,
           SCR   = round(ssr, 2))
```
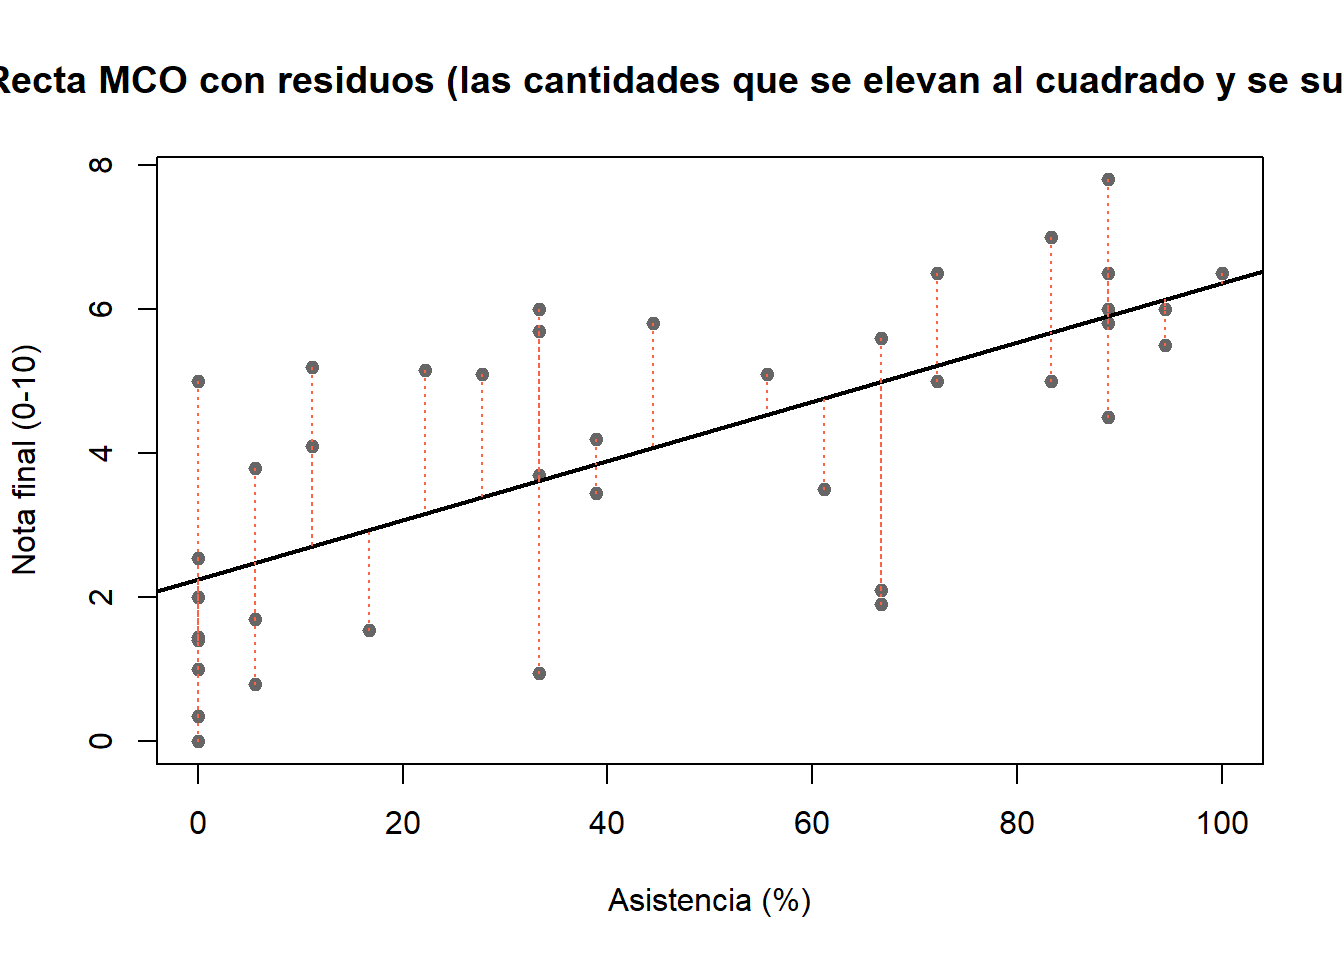
Cada recta candidata da una suma de cuadrados de los residuos (SCR) distinta. MCO es el *único* par $(\hat\beta_0, \hat\beta_1)$ que minimiza esta suma --- la recta C en el gráfico anterior. La siguiente figura muestra los residuos (las cantidades que se elevan al cuadrado y se suman) como segmentos verticales discontinuos desde cada punto hasta la recta MCO.
```{r slr-ols-residuals-fig}
m <- lm(nota ~ asistencia)
plot(asistencia, nota,
     xlab = "Asistencia (%)", ylab = "Nota final (0-10)",
     pch = 19, col = "grey40", cex = 0.9,
     main = "Recta MCO con residuos (las cantidades que se elevan al cuadrado y se suman)")
abline(m, col = "black", lwd = 2)
yhat <- predict(m)
segments(asistencia, nota, asistencia, yhat,
         col = "tomato", lty = 3)
```
La definición formal del residuo $\hat u_i$ aparece en §2.4.1; la derivación algebraica de los minimizadores $\hat\beta_0$ y $\hat\beta_1$ se desarrolla en §2.4.3. La intuición visual nos acompaña en todo el capítulo: MCO es la recta que hace que la suma de los segmentos discontinuos al cuadrado sea lo más pequeña posible.
::: {.callout-note appearance="simple"}
*Data: 41 estudiantes de Econometría I, curso 2024--25, UGR (recogidos por el autor).*
:::
### El residuo
Para cada observación $i$, el **residuo** es la distancia vertical entre el valor observado $y_i$ y el valor predicho por la FRM:
$$
\hat u_i = y_i - \hat y_i = y_i - \hat\beta_0 - \hat\beta_1 x_i.
$$
El residuo es el análogo muestral de la perturbación poblacional $u_i$. Es observable en cuanto se dispone de las estimaciones $(\hat\beta_0, \hat\beta_1)$; la perturbación $u_i$, en cambio, *nunca* es observable.
### La suma de cuadrados de los residuos
Se busca la recta que haga los residuos lo más pequeños posible en algún sentido global. Elevarlos al cuadrado (en lugar de tomar valores absolutos) penaliza con más fuerza las desviaciones grandes y produce una función objetivo suave y diferenciable. El método de MCO elige $\hat\beta_0$ y $\hat\beta_1$ de modo que minimicen la **Suma de Cuadrados de los Residuos (SCR)**:
$$
\mathrm{SCR} = \sum_{i=1}^{n} \hat u_i^{\,2} = \sum_{i=1}^{n}\bigl(y_i - \hat\beta_0 - \hat\beta_1 x_i\bigr)^2.
$$
### Derivación de los estimadores MCO
Derivando $\mathrm{SCR}$ respecto a $\hat\beta_0$ y $\hat\beta_1$ e igualando a cero se obtienen las **condiciones de primer orden (CPO)**:
$$
-2\sum_{i=1}^{n}\bigl(y_i - \hat\beta_0 - \hat\beta_1 x_i\bigr) = 0, \qquad
-2\sum_{i=1}^{n} x_i\bigl(y_i - \hat\beta_0 - \hat\beta_1 x_i\bigr) = 0.
$$
La primera CPO, dividida entre $n$, da $\bar y - \hat\beta_0 - \hat\beta_1 \bar x = 0$, de donde
$$
\hat\beta_0 = \bar y - \hat\beta_1 \bar x.
$$
Sustituyendo esta expresión en la segunda CPO y simplificando, se obtiene la célebre fórmula de la pendiente:
$$
\hat\beta_1 = \frac{\sum_{i=1}^{n}(x_i - \bar x)(y_i - \bar y)}{\sum_{i=1}^{n}(x_i - \bar x)^2} = \frac{\widehat{\operatorname{Cov}}(x,y)}{\widehat{\operatorname{Var}}(x)}.
$$
La pendiente es la covarianza muestral entre $x$ e $y$ dividida entre la varianza muestral de $x$. Dos consecuencias son inmediatas:
- La pendiente MCO es una **medida escalada de asociación**. Si en la muestra $x$ e $y$ están positivamente correlacionados, $\hat\beta_1 > 0$; si están incorrelacionados, $\hat\beta_1 = 0$.
- La fórmula exige $\sum_{i=1}^{n}(x_i - \bar x)^2 > 0$, es decir, debe haber **variación en $x$**. Si todas las observaciones comparten el mismo valor de $x$, el denominador se anula y MCO queda indefinido --- simplemente no hay forma de aprender cómo responde $y$ a $x$ si $x$ nunca se mueve.
::: {.callout-note}
## Ejemplo: salario y educación
Supongamos una muestra de $n = 1\,000$ trabajadores en la que se obtiene
$$
\widehat{\text{Salario}} = 800 + 15 \times \text{Educación}.
$$
Léase:
- $\hat\beta_0 = 800$: el salario mensual predicho para alguien con cero años de educación es de 800\ €/mes (extrapolación fuera del rango de los datos).
- $\hat\beta_1 = 15$: un año adicional de escolarización se asocia, en media, con 15\ €/mes más.
:::
La solución MCO posee tres propiedades mecánicas que se derivan directamente de las condiciones de primer orden y que se emplearán de forma recurrente:
1. $\sum_{i=1}^{n} \hat u_i = 0$ --- los residuos suman cero.
2. $\sum_{i=1}^{n} x_i \hat u_i = 0$ --- los residuos están incorrelacionados con $x$ en la muestra.
3. La recta MCO pasa por el punto $(\bar x, \bar y)$ --- consecuencia directa de $\hat\beta_0 = \bar y - \hat\beta_1 \bar x$.
Se trata de propiedades **algebraicas** de MCO: se cumplen por construcción en *cualquier* muestra, con independencia del proceso generador de los datos. No son propiedades estadísticas sobre la población.
## Los supuestos de Gauss--Markov para la RLS
MCO produce un número a partir de cualquier muestra, pero para que ese número tenga buenas propiedades *estadísticas* --- insesgadez, varianza mínima, errores estándar interpretables --- se necesitan supuestos sobre la población. Los cinco **supuestos de Gauss--Markov para la RLS** son la base del resto del capítulo.
**RLS.1 --- Linealidad en los parámetros.** El modelo poblacional se escribe como
$$
y = \beta_0 + \beta_1 x + u,
$$
donde $\beta_0$ y $\beta_1$ son los parámetros desconocidos y $u$ es la perturbación no observable.
**RLS.2 --- Muestreo aleatorio.** Se dispone de una muestra aleatoria $\{(x_i, y_i) : i = 1, \ldots, n\}$ extraída de la población descrita en RLS.1.
**RLS.3 --- Variación muestral en $x$.** Los valores muestrales $x_1, x_2, \ldots, x_n$ no son todos iguales: $\sum_{i=1}^{n}(x_i - \bar x)^2 > 0$.
**RLS.4 --- Media condicional cero.** El error tiene esperanza nula para cualquier valor de $x$:
$$
\mathbb{E}[u \mid x] = 0.
$$
**RLS.5 --- Homocedasticidad.** La varianza del error es constante en $x$:
$$
\operatorname{Var}(u \mid x) = \sigma^2.
$$
::: {.callout-warning}
## Error frecuente: confundir qué hace cada supuesto
RLS.1--RLS.3 son condiciones técnicas que aseguran que el estimador esté bien definido. RLS.4 es lo que hace al estimador **insesgado** y permite interpretar $\beta_1$ como un efecto *ceteris paribus*; es también el supuesto más difícil de verificar y el que con más frecuencia se viola en la práctica. RLS.5 solo se necesita para la fórmula de la **varianza** y para el resultado de eficiencia de Gauss--Markov, no para la insesgadez.
:::
## Insesgadez de MCO
Bajo RLS.1--RLS.4 los estimadores MCO son insesgados. Se esboza el argumento para $\hat\beta_1$; el álgebra para $\hat\beta_0$ es análoga.
Partiendo de la fórmula MCO y sustituyendo el modelo poblacional $y_i = \beta_0 + \beta_1 x_i + u_i$:
$$
\hat\beta_1 = \frac{\sum_{i=1}^{n}(x_i - \bar x)(y_i - \bar y)}{\sum_{i=1}^{n}(x_i - \bar x)^2} = \beta_1 + \frac{\sum_{i=1}^{n}(x_i - \bar x)\,u_i}{\sum_{i=1}^{n}(x_i - \bar x)^2}.
$$
El segundo término es un promedio ponderado de los errores no observables, con pesos $(x_i - \bar x)/\mathrm{SCT}_x$ que suman cero. Tomando la esperanza condicional dada $\mathbf{x} = (x_1, \ldots, x_n)$ y aplicando RLS.4 ($\mathbb{E}[u_i \mid x_i] = 0$ para todo $i$),
$$
\mathbb{E}[\hat\beta_1 \mid \mathbf{x}] = \beta_1 + \frac{\sum_{i=1}^{n}(x_i - \bar x)\,\mathbb{E}[u_i \mid \mathbf{x}]}{\sum_{i=1}^{n}(x_i - \bar x)^2} = \beta_1.
$$
Por la ley de esperanzas iteradas, $\mathbb{E}[\hat\beta_1] = \beta_1$. El mismo argumento aplicado a $\hat\beta_0 = \bar y - \hat\beta_1 \bar x$ da $\mathbb{E}[\hat\beta_0] = \beta_0$.
::: {.callout-note}
## La insesgadez es propiedad del estimador, no de una estimación concreta
La igualdad $\mathbb{E}[\hat\beta_1] = \beta_1$ *no* dice «nuestro número es exactamente correcto». Dice que si extrajésemos muchas muestras independientes de la misma población y calculásemos $\hat\beta_1$ en cada una, el promedio a largo plazo de todas esas estimaciones coincidiría con $\beta_1$. Cualquier estimación individual puede estar por encima o por debajo de la verdad.
:::
## Varianzas muestrales de los estimadores MCO
¿Cómo de precisas son las estimaciones MCO? Bajo RLS.1--RLS.5, condicionando en los regresores,
$$
\operatorname{Var}(\hat\beta_1 \mid \mathbf{x}) = \frac{\sigma^2}{\sum_{i=1}^{n}(x_i - \bar x)^2} = \frac{\sigma^2}{\mathrm{SCT}_x},
$$
$$
\operatorname{Var}(\hat\beta_0 \mid \mathbf{x}) = \frac{\sigma^2 \sum_{i=1}^{n} x_i^{\,2}}{n\sum_{i=1}^{n}(x_i - \bar x)^2}.
$$
Tres factores explican la precisión de $\hat\beta_1$:
1. **Varianza del error $\sigma^2$.** Datos más ruidosos producen estimaciones menos precisas. Añadir buenos controles en el Capítulo 3 reducirá $\sigma^2$ y estrechará nuestras estimaciones.
2. **Variación en $x$ (la dispersión del regresor, $\mathrm{SCT}_x$).** Un regresor que apenas se mueve resulta poco informativo; uno que recorre un rango amplio identifica con nitidez la pendiente.
3. **Tamaño muestral $n$.** Una muestra mayor suele elevar $\mathrm{SCT}_x$, lo que reduce directamente $\operatorname{Var}(\hat\beta_1)$.
Estos tres factores reaparecen, con forma similar, en todos los modelos de regresión del resto del libro.
## El teorema de Gauss--Markov
El resultado fundamental que justifica usar MCO es el **teorema de Gauss--Markov**.
> Bajo RLS.1--RLS.5, los estimadores MCO $\hat\beta_0$ y $\hat\beta_1$ son los **Estimadores Lineales Insesgados Óptimos (ELIO; *Best Linear Unbiased Estimators*, BLUE)** de $\beta_0$ y $\beta_1$.
«Mejores» significa de *varianza mínima* en la clase de todos los estimadores que son (i) lineales en $y$ e (ii) insesgados para $\beta$. La demostración considera un competidor arbitrario lineal e insesgado $\tilde\beta_1 = \sum_i w_i y_i$, escribe los pesos como $w_i = (x_i - \bar x)/\mathrm{SCT}_x + d_i$ para alguna desviación $d_i$, impone las condiciones $\sum_i d_i = 0$ y $\sum_i d_i x_i = 0$ exigidas por la insesgadez, y calcula
$$
\operatorname{Var}(\tilde\beta_1 \mid \mathbf{x}) = \frac{\sigma^2}{\mathrm{SCT}_x} + \sigma^2 \sum_{i=1}^{n} d_i^{\,2} \geq \frac{\sigma^2}{\mathrm{SCT}_x} = \operatorname{Var}(\hat\beta_1 \mid \mathbf{x}),
$$
con igualdad solo si $d_i = 0$ para todo $i$, esto es, cuando $\tilde\beta_1 = \hat\beta_1$.
::: {.callout-warning}
## Lo que el teorema de Gauss--Markov *no* dice
El teorema **no** afirma que MCO sea el mejor estimador en algún sentido absoluto. Dice: entre los estimadores *lineales* e *insesgados*, MCO tiene varianza mínima. Pueden existir estimadores *sesgados* (ridge, LASSO) o *no lineales* (regresión por cuantiles) con menor error cuadrático medio en contextos concretos.
:::
## Estimación de $\sigma^2$
La varianza del error $\sigma^2$ aparece en las fórmulas de varianza anteriores, pero es a su vez desconocida: nunca observamos los errores poblacionales $u_i$, solo los residuos $\hat u_i$. El estimador muestral natural es
$$
\hat\sigma^2 = \frac{\mathrm{SCR}}{n - 2} = \frac{\sum_{i=1}^{n} \hat u_i^{\,2}}{n - 2}.
$$
Bajo RLS.1--RLS.5 este estimador es insesgado: $\mathbb{E}[\hat\sigma^2] = \sigma^2$. Se divide entre $n - 2$ (y no entre $n$) porque ya se han «consumido» dos grados de libertad al estimar $\beta_0$ y $\beta_1$ a partir de los mismos datos. La raíz cuadrada $\hat\sigma$ se conoce como **error estándar de la regresión** (R la muestra como *Residual standard error*).
Combinando $\hat\sigma^2$ con la fórmula de la varianza se obtiene el **error estándar** de la estimación de la pendiente:
$$
\operatorname{se}(\hat\beta_1) = \frac{\hat\sigma}{\sqrt{\mathrm{SCT}_x}}.
$$
El error estándar es el caballo de batalla de la inferencia en el Capítulo 4: todo lo que diremos sobre intervalos de confianza y contrastes $t$ se construye sobre él.
## Bondad de ajuste: $R^2$
Dos regresiones pueden tener idéntica estimación de la pendiente y, sin embargo, ajustes muy distintos, según qué fracción de la variación de $y$ logre explicar el regresor. Para medir el ajuste se descompone la variación total de $y$:
$$
\underbrace{\sum_{i=1}^{n}(y_i - \bar y)^2}_{\mathrm{SCT}}
\;=\; \underbrace{\sum_{i=1}^{n}(\hat y_i - \bar y)^2}_{\mathrm{SCE}}
\;+\; \underbrace{\sum_{i=1}^{n} \hat u_i^{\,2}}_{\mathrm{SCR}},
$$
donde $\mathrm{SCT}$ es la *Suma de Cuadrados Total*, $\mathrm{SCE}$ es la *Suma de Cuadrados Explicada* y $\mathrm{SCR}$ es la *Suma de Cuadrados de los Residuos*. La descomposición se apoya en las propiedades algebraicas de MCO ($\sum_i \hat u_i = 0$ y $\sum_i x_i \hat u_i = 0$); no se cumpliría para una recta cualquiera.
El **coeficiente de determinación** es entonces
$$
R^2 = \frac{\mathrm{SCE}}{\mathrm{SCT}} = 1 - \frac{\mathrm{SCR}}{\mathrm{SCT}}.
$$
$R^2$ es la fracción de la variación muestral de $y$ «explicada» por $x$. Toma valores entre 0 y 1: vale 1 cuando todos los puntos caen sobre la recta y vale 0 cuando $\hat\beta_1 = 0$. En la regresión lineal simple, $R^2$ coincide con el cuadrado del coeficiente de correlación muestral entre $y$ y $x$.
::: {.callout-warning}
## Un $R^2$ bajo *no* significa que el modelo sea inútil
En economía laboral, de la salud o de la educación, valores de $R^2$ del 5--15\ % son completamente normales: los resultados individuales dependen de muchos factores que nunca medimos. Un $R^2$ pequeño *no* invalida por sí solo la estimación de la pendiente --- $\hat\beta_1$ puede seguir siendo insesgado, estadísticamente significativo y relevante para la política económica. A la inversa, un $R^2$ elevado *no* valida un modelo en el que falle RLS.4: $\hat\beta_1$ puede estimarse con precisión y estar, aun así, gravemente sesgado [@cgl2017].
:::
## Práctica: RLS en R
En esta práctica se estiman dos regresiones simples utilizando el paquete **wooldridge**: la regresión salario--apariencia de §2.4 («Práctica A») y la regresión peso al nacer--tabaquismo materno («Práctica B»). Ambas son secciones cruzadas pequeñas, ambas presentan $R^2$ reducidos y ambas ilustran la advertencia anterior.
```{r ch02-setup}
#| message: false
library(wooldridge)
data("beauty")
data("bwght")
```
### Práctica A --- Salario y apariencia física (`beauty`)
El conjunto de datos `beauty`, empleado por Hamermesh y Biddle (1994) y reproducido en @wooldridge2020, contiene salarios por hora y una valoración de la apariencia física en una escala de cinco puntos para una muestra de trabajadores estadounidenses. La variable `looks` toma valores enteros de 1 («poco agraciado») a 5 («muy atractivo»), siendo 3 «en la media». La variable `wage` es el salario por hora en dólares estadounidenses.
Se comienza con estadísticos descriptivos y una tabla de frecuencias de `looks`.
```{r ch02-beauty-summary}
summary(beauty$wage)
summary(beauty$looks)
table(beauty$looks)
```
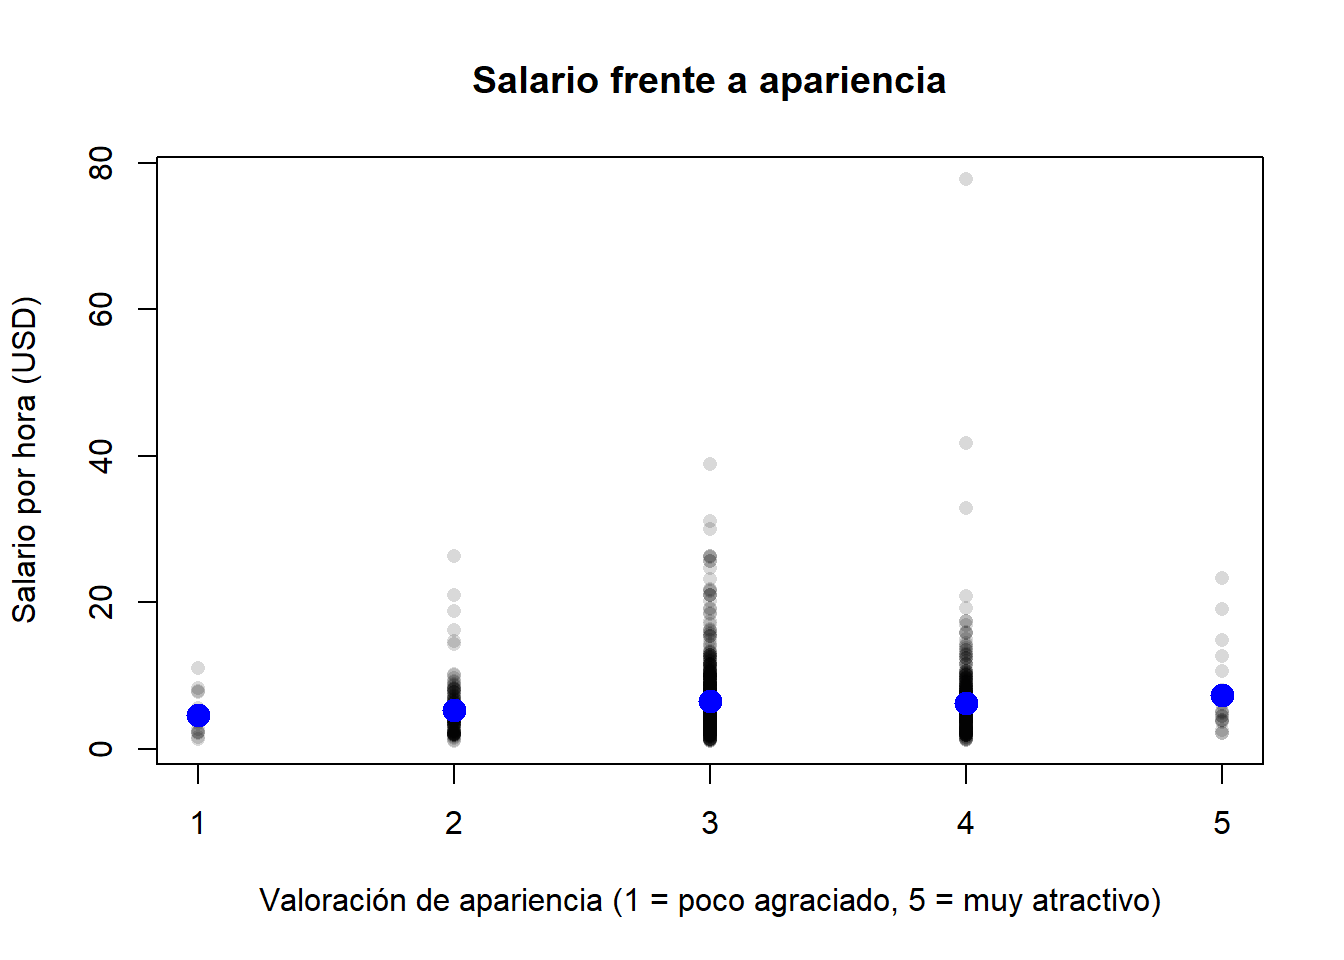
La gran mayoría de los trabajadores recibe la valoración 3 («en la media»); las categorías extremas 1 y 5 son escasas. Esto ya nos avisa de que la pendiente de la regresión de salario sobre apariencia vendrá determinada casi en exclusiva por el contraste entre las categorías 2, 3 y 4.
Antes de cualquier regresión, calcúlese el salario medio en cada categoría de apariencia. Es la media condicional *no paramétrica* y servirá de referencia frente a la cual comparar el ajuste MCO.
```{r ch02-beauty-condmean}
tapply(beauty$wage, beauty$looks, mean)
```
Los salarios medios crecen (modestamente y no de forma estrictamente monótona) con la apariencia. El resumen natural de este patrón en un único número es la pendiente de la recta MCO.
Un diagrama de dispersión con las medias condicionales superpuestas hace visible la historia.
```{r ch02-beauty-scatter}
#| fig-cap: "Salario por hora frente a valoración de apariencia (beauty). Los puntos azules son medias condicionales por categoría."
cm <- tapply(beauty$wage, beauty$looks, mean)
plot(beauty$looks, beauty$wage,
     xlab = "Valoración de apariencia (1 = poco agraciado, 5 = muy atractivo)",
     ylab = "Salario por hora (USD)",
     main = "Salario frente a apariencia",
     pch = 16, col = rgb(0, 0, 0, 0.15))
points(as.numeric(names(cm)), cm, pch = 19, col = "blue", cex = 1.6)
```
Estímese ahora la regresión lineal simple del salario sobre la apariencia con `lm()`:
```{r ch02-beauty-lm}
fit_beauty <- lm(wage ~ looks, data = beauty)
summary(fit_beauty)
```
Antes de leer la salida de R, es instructivo replicar a mano la fórmula de §2.4.3:
```{r ch02-beauty-manual}
b1 <- cov(beauty$wage, beauty$looks) / var(beauty$looks)
b0 <- mean(beauty$wage) - b1 * mean(beauty$looks)
c(b0 = b0, b1 = b1)
```
Las dos cifras coinciden con los coeficientes que devuelve `lm()`, como es de esperar: `lm()` no hace nada distinto de aplicar las fórmulas del §2.4.3.
Interpretación de la salida:
- El intercepto estimado $\hat\beta_0$ es el salario predicho para un trabajador con `looks = 0` --- un valor fuera del rango de los datos, por lo que carece de interpretación económica directa.
- La pendiente estimada $\hat\beta_1$ sobre `looks` es el cambio en el salario predicho por cada punto adicional en la valoración de apariencia. Un trabajador valorado 4 («por encima de la media») gana aproximadamente $\hat\beta_1$ dólares por hora más, en media, que uno valorado 3 («en la media»).
- El error estándar de $\hat\beta_1$, el estadístico $t$ y el $p$-valor permiten contrastar si la pendiente es estadísticamente distinta de cero. Se tratan formalmente en el Capítulo 4; por ahora basta con notar que la pendiente es significativamente distinta de cero a los niveles habituales.
- El **Residual standard error** al pie de `summary()` es $\hat\sigma$ del §2.9.
- El **Multiple R-squared** es el $R^2$ del §2.10. Es pequeño (1--2\ %): la apariencia explica por sí sola una fracción ínfima de la variación de los salarios. Eso no invalida la pendiente --- simplemente recuerda que el salario depende de muchas otras cosas (educación, experiencia, ocupación...) que se incorporarán como controles en el Capítulo 3.
Para cerrar, superpóngase la recta MCO al diagrama de dispersión:
```{r ch02-beauty-fitline}
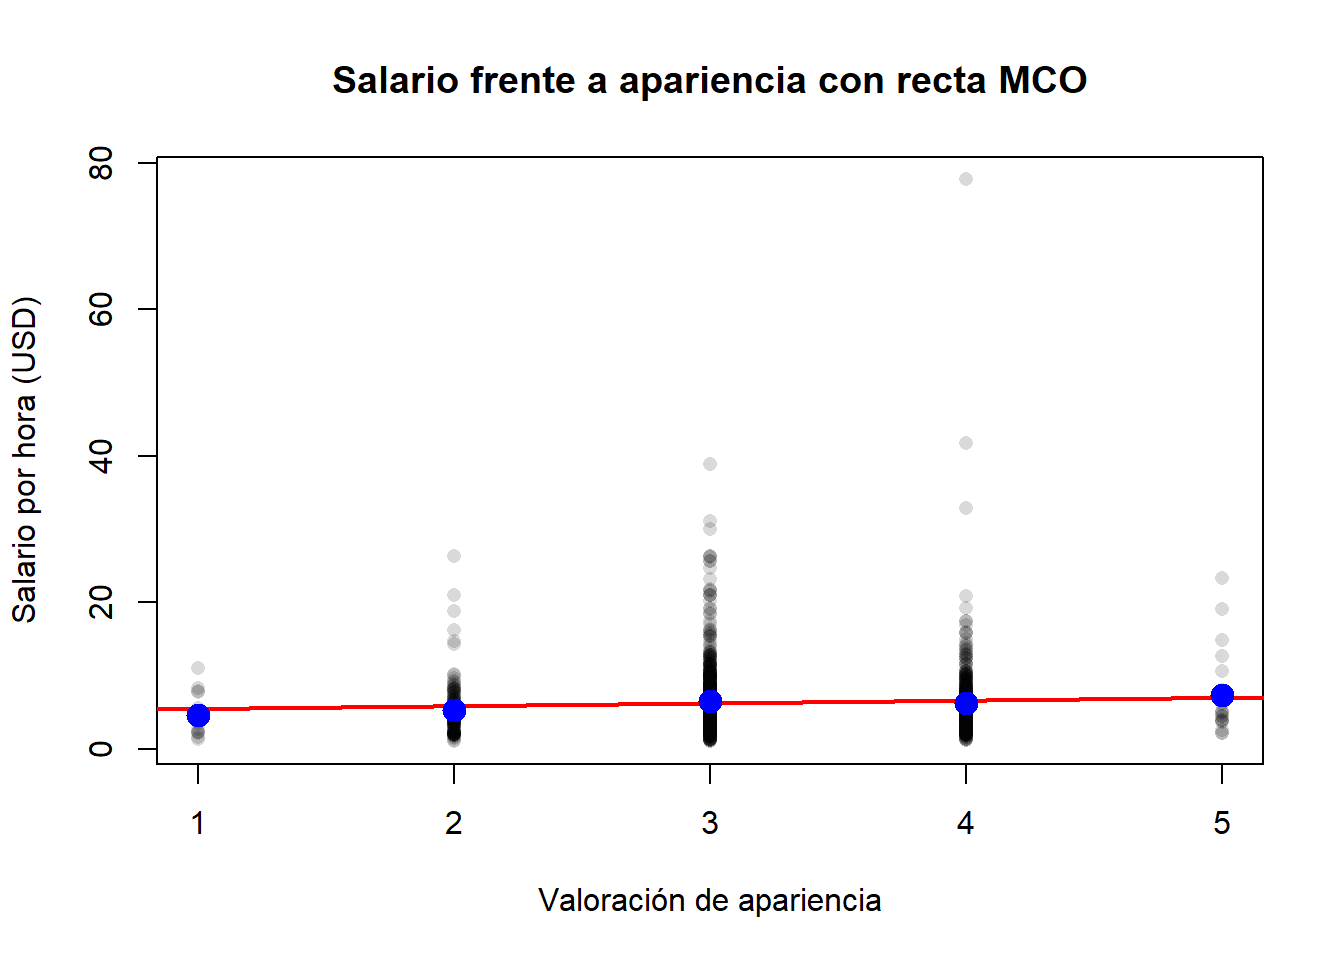
#| fig-cap: "Recta MCO y medias condicionales para la regresión salario--apariencia."
plot(beauty$looks, beauty$wage,
     xlab = "Valoración de apariencia", ylab = "Salario por hora (USD)",
     main = "Salario frente a apariencia con recta MCO",
     pch = 16, col = rgb(0, 0, 0, 0.15))
abline(fit_beauty, col = "red", lwd = 2)
points(as.numeric(names(cm)), cm, pch = 19, col = "blue", cex = 1.6)
```
La recta roja MCO aproxima la tendencia de las medias condicionales azules pero no las interpola exactamente: el modelo lineal es una *aproximación*.
Una comprobación útil consiste en verificar la descomposición $\mathrm{SCT} = \mathrm{SCE} + \mathrm{SCR}$ y la identidad $R^2 = 1 - \mathrm{SCR}/\mathrm{SCT}$ del §2.10:
```{r ch02-beauty-r2}
yhat <- fitted(fit_beauty)
uhat <- resid(fit_beauty)
y    <- beauty$wage
SCT  <- sum((y - mean(y))^2)
SCE  <- sum((yhat - mean(y))^2)
SCR  <- sum(uhat^2)
c(SCT = SCT, SCE_mas_SCR = SCE + SCR)
c(R2_manual = 1 - SCR / SCT, R2_lm = summary(fit_beauty)$r.squared)
```
Cada pareja de números coincide (salvo redondeo numérico), tal como predice la teoría.
### Práctica B --- Peso al nacer y tabaquismo materno (`bwght`)
El conjunto de datos `bwght` registra el peso al nacer (en onzas) y el consumo medio diario de cigarrillos de la madre durante el embarazo, entre otras variables, para una muestra de nacimientos en Estados Unidos. El tabaquismo materno es uno de los determinantes del peso al nacer más estudiados, con un mecanismo médico claro a favor de un efecto *negativo*.
```{r ch02-bwght-summary}
summary(bwght$bwght)
summary(bwght$cigs)
mean(bwght$cigs)
```
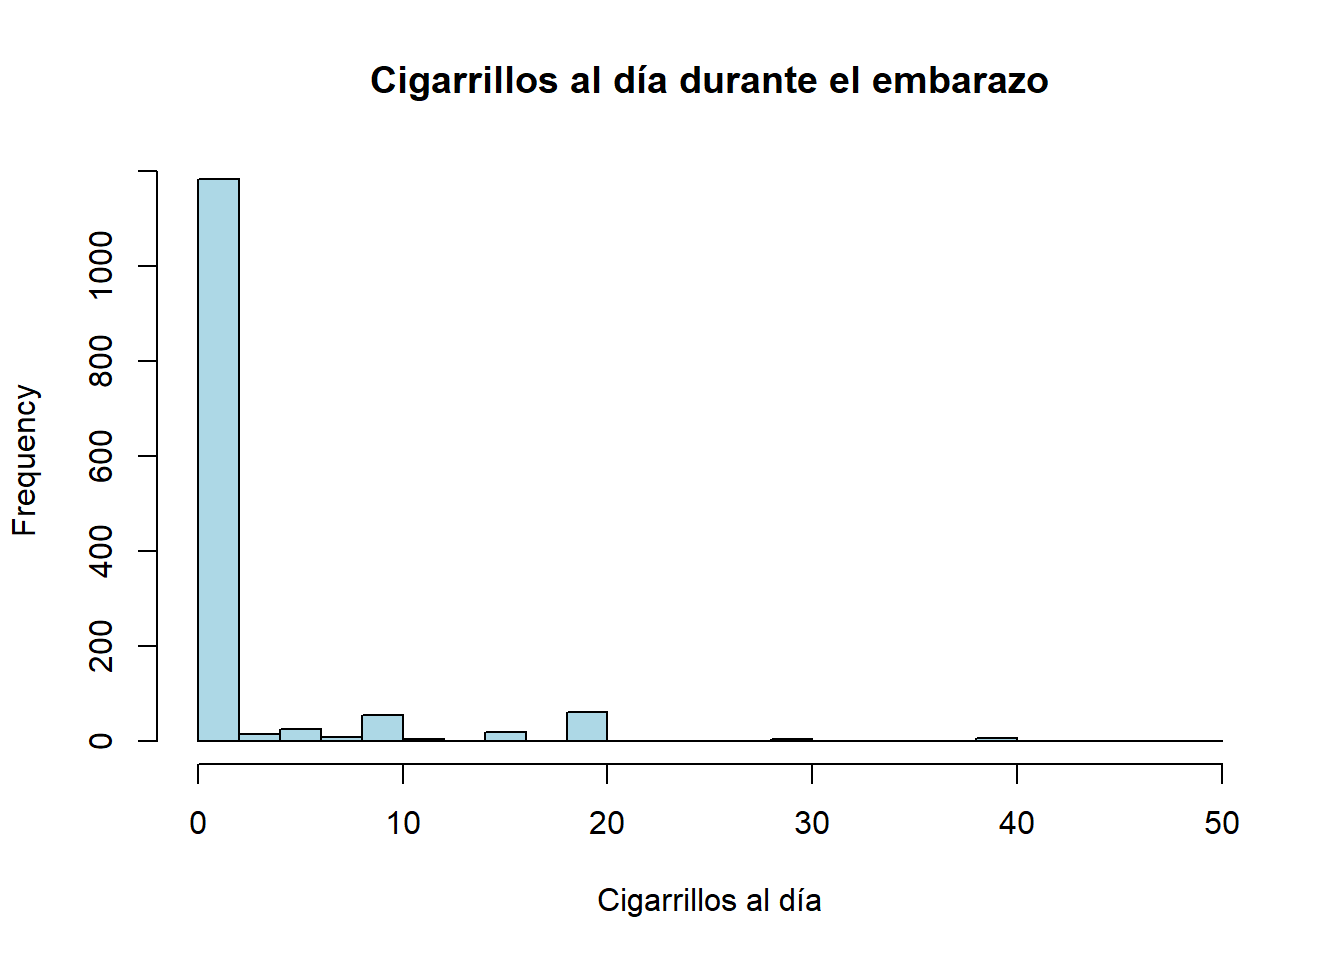
La mayoría de las madres de la muestra no fuman (la mediana de `cigs` es cero). Entre quienes sí fuman, el consumo diario puede llegar a 50 cigarrillos. El histograma hace evidente la pesada cola a la derecha:
```{r ch02-bwght-hist}
#| fig-cap: "Distribución de cigarrillos al día durante el embarazo (bwght)."
hist(bwght$cigs,
     main  = "Cigarrillos al día durante el embarazo",
     xlab  = "Cigarrillos al día",
     col   = "lightblue",
     breaks = 20)
```
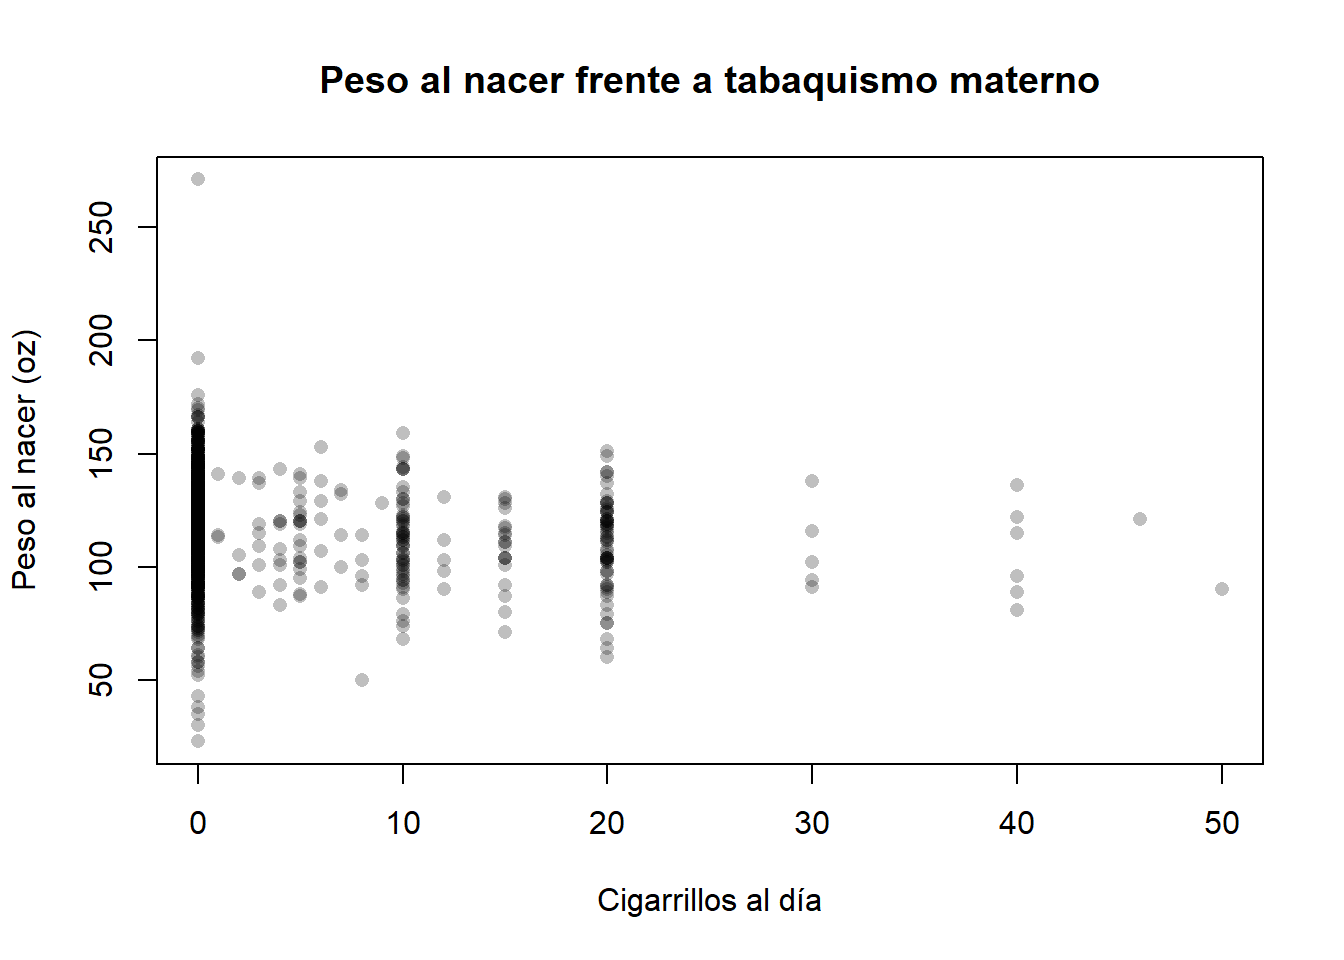
Diagrama de dispersión del peso al nacer frente al consumo de cigarrillos:
```{r ch02-bwght-scatter}
#| fig-cap: "Peso al nacer en onzas frente a cigarrillos al día."
plot(bwght$cigs, bwght$bwght,
     xlab = "Cigarrillos al día",
     ylab = "Peso al nacer (oz)",
     main = "Peso al nacer frente a tabaquismo materno",
     pch  = 16, col = rgb(0, 0, 0, 0.25))
```
Ahora la regresión lineal simple de `bwght` sobre `cigs`:
```{r ch02-bwght-lm}
fit_bwght <- lm(bwght ~ cigs, data = bwght)
summary(fit_bwght)
plot(bwght$cigs, bwght$bwght,
     xlab = "Cigarrillos al día",
     ylab = "Peso al nacer (oz)",
     main = "Peso al nacer frente a tabaquismo materno (recta ajustada)",
     pch  = 16, col = rgb(0, 0, 0, 0.25))
abline(fit_bwght, col = "red", lwd = 2)
```
Interpretación:
- $\hat\beta_0$ es el peso al nacer predicho para un bebé cuya madre *no* fuma durante el embarazo (`cigs = 0`). A diferencia de la regresión `beauty`, este valor sí tiene sentido económico/médico porque la mediana de `cigs` es cero.
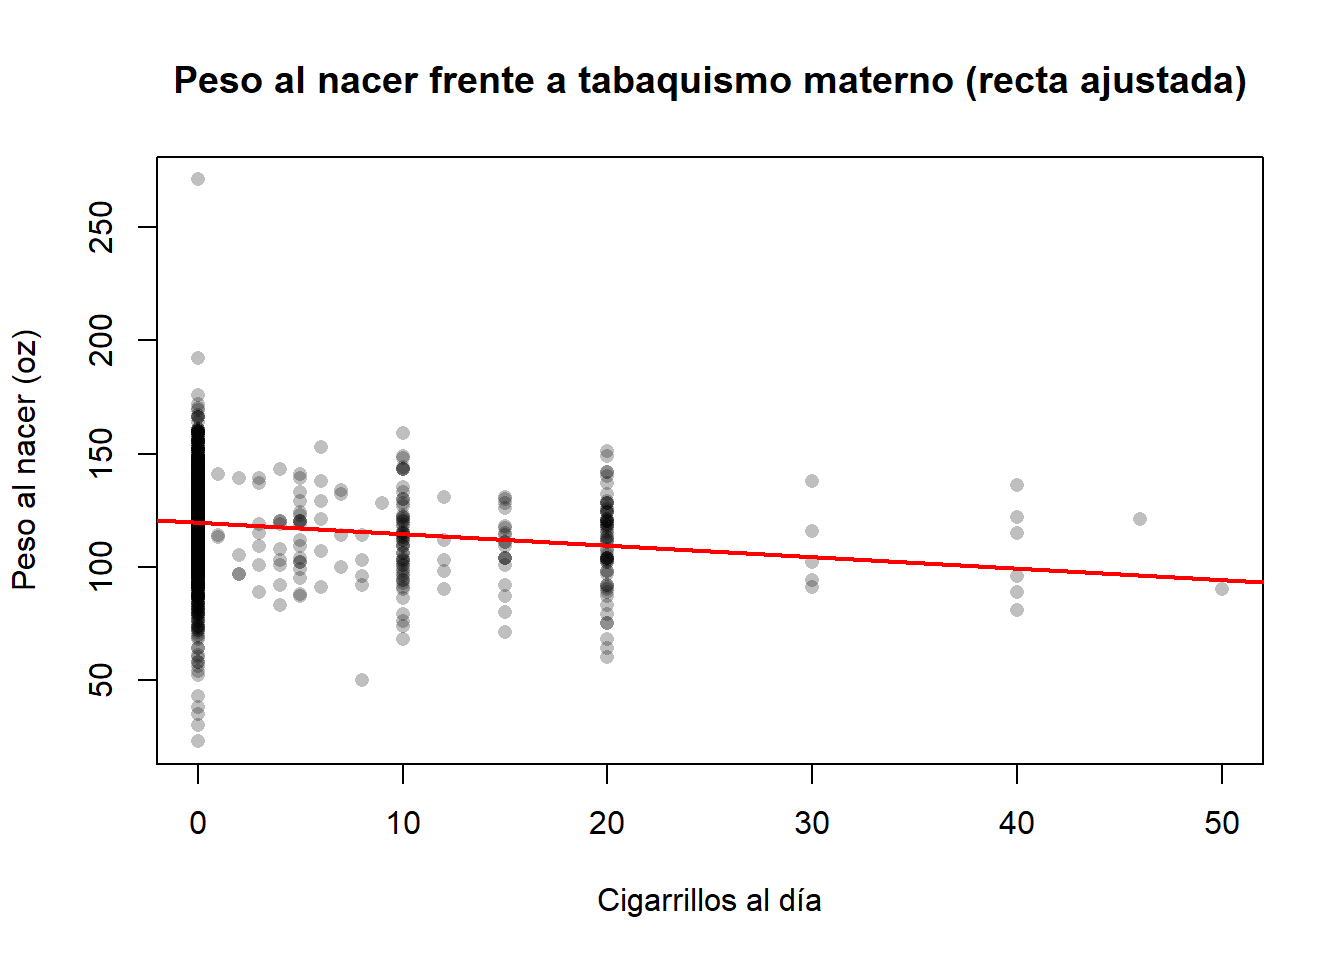
- $\hat\beta_1$ es el cambio en el peso predicho por cada cigarrillo adicional al día. La pendiente estimada es aproximadamente $-0{,}51$ onzas por cigarrillo, de modo que fumar diez cigarrillos más al día se asocia con unos $10 \times (-0{,}51) \approx -5{,}1$ onzas menos de peso al nacer. El signo negativo concuerda con la evidencia médica.
- El $R^2$ es de nuevo pequeño. El peso al nacer depende de docenas de factores --- nutrición materna, edad, partos previos, atención prenatal --- y `cigs` es solo uno de ellos. Como en la Práctica A, un $R^2$ bajo no invalida la estimación de la pendiente.
Si el $-0{,}51$ estimado es o no el efecto *causal* del tabaco sobre el peso al nacer es otra cuestión. Si las madres fumadoras también difieren de las no fumadoras en renta, educación o nutrición, y esas características afectan al peso al nacer por sí mismas, entonces RLS.4 falla y $\hat\beta_1$ está sesgado --- un caso de **sesgo de variable omitida (SVO)**. Volveremos a este mismo conjunto de datos en el Capítulo 3, una vez dispongamos de las herramientas de regresión múltiple necesarias para tratarlo.
## Auto-evaluación {.unnumbered}
Siete preguntas tipo test cortas. Inténtelas antes de desplegar la respuesta.
::: {.callout-tip collapse="true"}
## P1. La pendiente $\beta_1$
En el modelo de regresión simple $y = \beta_0 + \beta_1 x + u$, la pendiente $\beta_1$ mide:
- A. La correlación entre $x$ e $y$.
- B. El cambio esperado en $y$ cuando $x$ aumenta una unidad, manteniendo fijos todos los factores en $u$.
- C. El valor esperado de $y$ cuando $x = 0$.
- D. La fracción de la varianza de $y$ explicada por $x$.
**Respuesta: B.** $\beta_1$ es el cambio *ceteris paribus* en la media condicional de $y$. C describe el intercepto $\beta_0$; A es la correlación (una cantidad distinta, libre de escala); D es el $R^2$.
:::
::: {.callout-tip collapse="true"}
## P2. El supuesto de media condicional cero
El supuesto $\mathbb{E}[u \mid x] = 0$ implica:
- A. Que el error $u$ se distribuye normalmente.
- B. Que $\operatorname{Var}(u \mid x)$ es constante en $x$.
- C. Que $\mathbb{E}[u] = 0$ y $\operatorname{Cov}(x, u) = 0$.
- D. Que $x$ se mide sin error.
**Respuesta: C.** La media condicional cero implica tanto media incondicional cero (por esperanzas iteradas) como covarianza nula entre $x$ y $u$. B es el supuesto independiente de homocedasticidad (RLS.5); A y D no guardan relación.
:::
::: {.callout-tip collapse="true"}
## P3. La fórmula MCO de la pendiente
El estimador MCO de $\beta_1$ en la regresión simple $y = \beta_0 + \beta_1 x + u$ se escribe como:
- A. $\hat\beta_1 = \bar y / \bar x$.
- B. $\hat\beta_1 = \widehat{\operatorname{Var}}(y) / \widehat{\operatorname{Cov}}(x, y)$.
- C. $\hat\beta_1 = \widehat{\operatorname{Cov}}(x, y) / \widehat{\operatorname{Var}}(x)$.
- D. $\hat\beta_1 = \bar y - \hat\beta_0 \bar x$.
**Respuesta: C.** La pendiente es la covarianza muestral entre $x$ e $y$ entre la varianza muestral de $x$. D es (una versión reordenada de) la fórmula del intercepto; A y B no son estimadores MCO.
:::
::: {.callout-tip collapse="true"}
## P4. Propiedades mecánicas de los residuos MCO
¿Cuál de las siguientes **NO** es una propiedad algebraica de los residuos MCO $\hat u_i$?
- A. $\sum_i \hat u_i = 0$.
- B. $\sum_i x_i \hat u_i = 0$.
- C. La recta MCO pasa por $(\bar x, \bar y)$.
- D. Los $\hat u_i$ están incorrelacionados con el error no observado $u_i$.
**Respuesta: D.** A, B y C se deducen directamente de las condiciones de primer orden y se cumplen en cualquier muestra. D es un enunciado sobre la perturbación poblacional $u_i$, que nunca es observable; no hay ninguna identidad algebraica que relacione $\hat u_i$ con $u_i$.
:::
::: {.callout-tip collapse="true"}
## P5. Insesgadez frente a ELIO
Bajo RLS.1--RLS.4 únicamente (sin homocedasticidad), MCO es:
- A. Insesgado: $\mathbb{E}[\hat\beta_j] = \beta_j$.
- B. El Estimador Lineal Insesgado Óptimo (ELIO / BLUE).
- C. Consistente pero sesgado.
- D. Normalmente distribuido.
**Respuesta: A.** La insesgadez requiere únicamente RLS.1--RLS.4. Añadir RLS.5 (homocedasticidad) es lo que eleva MCO a la condición de ELIO, vía el teorema de Gauss--Markov.
:::
::: {.callout-tip collapse="true"}
## P6. Precisión de $\hat\beta_1$
¿Cuál de los siguientes factores aumenta la precisión de $\hat\beta_1$ (varianza muestral menor)?
- A. Una varianza del error $\sigma^2$ mayor.
- B. Un tamaño muestral menor.
- C. Menos variación en $x$.
- D. Más variación en $x$ (mayor $\mathrm{SCT}_x$).
**Respuesta: D.** La fórmula de la varianza es $\operatorname{Var}(\hat\beta_1 \mid \mathbf{x}) = \sigma^2 / \mathrm{SCT}_x$. Un $\mathrm{SCT}_x$ mayor reduce la varianza. A y B hacen lo contrario; C es una reformulación de «menor precisión».
:::
::: {.callout-tip collapse="true"}
## P7. Qué nos dice (y qué no nos dice) el $R^2$
Un $R^2$ bajo en una regresión lineal simple significa:
- A. Que MCO es sesgado.
- B. Que $x$ no tiene efecto causal sobre $y$.
- C. Que $x$ explica una fracción pequeña de la variación de $y$, pero $\hat\beta_1$ puede seguir siendo insesgado y relevante.
- D. Que se incumplen los supuestos de Gauss--Markov.
**Respuesta: C.** El $R^2$ es una medida de ajuste, no de sesgo ni de causalidad. Un $R^2$ pequeño es perfectamente compatible con una pendiente insesgada y económicamente significativa, como muestran las prácticas de salario--apariencia y peso al nacer--tabaquismo.
:::
## Ejercicios {.unnumbered}
**Ejercicio 2.1 ★ --- Lectura de una ecuación estimada.** Una regresión sobre 1\,000 trabajadores produce la recta estimada $\widehat{\text{Salario}} = 800 + 15 \times \text{Educación}$, donde el salario está en euros mensuales y la educación en años.
(a) Interprete $\hat\beta_0$ y $\hat\beta_1$ verbalmente.
(b) ¿Cuál es el salario predicho para un trabajador con 12 años de escolarización?
(c) Dos trabajadores difieren en 4 años de escolarización. ¿En cuánto difieren sus salarios predichos?
(d) ¿Por qué conviene desconfiar de la predicción en `educ = 0`?
::: {.callout-tip collapse="true"}
## Mostrar respuesta
(a) $\hat\beta_0 = 800$ es el salario predicho para `educ = 0` (800\ €/mes). $\hat\beta_1 = 15$ es el aumento predicho en el salario mensual por cada año adicional de escolarización.
(b) $800 + 15 \times 12 = 980$\ €/mes.
(c) $4 \times 15 = 60$\ €/mes.
(d) Porque `educ = 0` queda muy por debajo del menor valor de cualquier muestra real de escolarización; la predicción es una *extrapolación* y puede no ser fiable.
:::
**Ejercicio 2.2 ★ --- Álgebra de MCO, a mano.** Considere los datos de juguete $x = (1, 2, 3, 4, 5)$ e $y = (3, 4, 2, 5, 6)$.
(a) Calcule $\bar x$ y $\bar y$.
(b) Calcule $\hat\beta_1$ con la fórmula del §2.4.3.
(c) Calcule $\hat\beta_0$.
(d) Verifique su resultado en R contrastándolo con `coef(lm(y ~ x))`.
::: {.callout-tip collapse="true"}
## Mostrar respuesta
(a) $\bar x = 3$, $\bar y = 4$.
(b) Numerador: $\sum (x_i - \bar x)(y_i - \bar y) = (-2)(-1) + (-1)(0) + 0(-2) + 1(1) + 2(2) = 2 + 0 + 0 + 1 + 4 = 7$. Denominador: $\sum (x_i - \bar x)^2 = 4 + 1 + 0 + 1 + 4 = 10$. Así, $\hat\beta_1 = 7/10 = 0{,}7$.
(c) $\hat\beta_0 = \bar y - \hat\beta_1 \bar x = 4 - 0{,}7 \times 3 = 1{,}9$.
(d) En R: `coef(lm(c(3,4,2,5,6) ~ c(1,2,3,4,5)))` devuelve los mismos números.
:::
**Ejercicio 2.3 ★ --- Varianza de la pendiente MCO.** Indique, en una frase cada uno, cómo cambia $\operatorname{Var}(\hat\beta_1)$ si:
(a) el tamaño muestral $n$ se duplica (manteniendo fija la distribución de $x$);
(b) la varianza del error $\sigma^2$ se duplica;
(c) el regresor $x$ se reescala de minutos a horas (se divide entre 60).
::: {.callout-tip collapse="true"}
## Mostrar respuesta
(a) $\mathrm{SCT}_x$ se duplica aproximadamente, por lo que la varianza se reduce a la mitad. (b) La varianza se duplica (es lineal en $\sigma^2$). (c) La varianza de la *pendiente sobre el regresor reescalado* se multiplica por $60^2 = 3600$: al escalar $x$ por $c$, $\hat\beta_1$ se multiplica por $1/c$, de modo que su varianza se multiplica por $1/c^2$.
:::
**Ejercicio 2.4 ★★ --- Cambio de unidades.** Demuestre que si se redefine el regresor como $x^* = c \cdot x$ (para una constante $c \neq 0$) sin modificar $y$, los nuevos estimadores MCO son $\hat\beta_1^* = \hat\beta_1 / c$ y $\hat\beta_0^* = \hat\beta_0$. Verifique la derivación empíricamente sobre `sleep75`: regrese `sleep` sobre `totwrk` (minutos por semana) y después sobre `totwrk/60` (horas por semana), y compruebe que el intercepto no cambia mientras que la pendiente se multiplica por 60.
*Una respuesta completa se ofrece en la Edición del Profesor.*
**Ejercicio 2.5 ★★ --- Insesgadez por simulación.** Simule $1\,000$ muestras de tamaño $n = 200$ del modelo $y = 1 + 2x + u$ con $x \sim N(0, 1)$ y $u \sim N(0, 1)$. Calcule $\hat\beta_1$ en cada muestra y compruebe que su media sobre las réplicas se aproxima a 2, mientras que la desviación típica entre réplicas se aproxima al valor teórico $\sigma / \sqrt{\mathrm{SCT}_x}$ para una extracción típica. Represente el histograma de $\hat\beta_1$.
*Una respuesta completa se ofrece en la Edición del Profesor.*
**Ejercicio 2.6 ★★★ --- Por qué prescindir del intercepto sesga la pendiente.** Suponga que el modelo verdadero es $y = \beta_0 + \beta_1 x + u$ con $\beta_0 \neq 0$ y $\mathbb{E}[u \mid x] = 0$, pero el investigador *impone* $\beta_0 = 0$ y ajusta la regresión por el origen $\tilde y_i = \tilde\beta_1 x_i$.
(a) Derive la expresión cerrada $\tilde\beta_1 = \sum_i x_i y_i / \sum_i x_i^2$ como minimizador de $\sum_i (y_i - \tilde\beta_1 x_i)^2$.
(b) Demuestre que $\mathbb{E}[\tilde\beta_1] = \beta_1 + \beta_0 \cdot \mathbb{E}[x] / \mathbb{E}[x^2]$, de modo que $\tilde\beta_1$ está sesgado siempre que $\beta_0 \neq 0$ y $\mathbb{E}[x] \neq 0$.
(c) ¿Bajo qué condición específica sobre la población es, no obstante, insesgada la pendiente sin intercepto?
*Una respuesta completa se ofrece en la Edición del Profesor.*