---
title: "Autocorrelación"
---
## Objetivos {.unnumbered}
Al finalizar este capítulo el lector debería ser capaz de:
- Explicar por qué la **autocorrelación** (o **correlación serial**) es el análogo en series temporales de la heterocedasticidad, y articular qué efecto tiene —y cuál *no* tiene— sobre el insesgamiento, la eficiencia y los errores estándar del estimador MCO.
- Escribir el modelo AR(1) para los errores, $u_t = \rho\,u_{t-1} + \varepsilon_t$, enunciar la condición de estacionariedad $|\rho|<1$ y derivar la media, la varianza y las autocovarianzas estacionarias.
- Detectar autocorrelación de primer orden de manera visual (gráfico temporal de residuos, gráfico de retardos $\hat u_t$ frente a $\hat u_{t-1}$) y formal (contraste de **Durbin-Watson**), utilizando las cotas $d_L$ y $d_U$ de las tablas y reconociendo las regiones de indeterminación.
- Reconocer las situaciones en las que el test de Durbin-Watson **no es válido** (presencia de retardos de la variable dependiente entre los regresores) y aplicar el **h-test de Durbin** como alternativa.
- Aplicar el procedimiento iterativo de **Cochrane-Orcutt** para obtener estimaciones eficientes por MCG factibles bajo errores AR(1), y comprender el papel de la modificación de **Prais-Winsten** para la primera observación.
- Implementar el flujo de trabajo completo en R con `lmtest::dwtest()` y `orcutt::cochrane.orcutt()`, contrastando los resultados de MCO con los corregidos sobre una regresión trimestral simulada de ventas frente a publicidad.
## Pregunta motivadora {.unnumbered}
> *¿Por qué las regresiones trimestrales de ventas sobre publicidad casi siempre producen estadísticos $t$ demasiado optimistas?*
Imaginemos a un analista de marketing que regresa las ventas trimestrales sobre el gasto en publicidad y una tendencia temporal, obtiene un estadístico $t$ de $7{,}4$ sobre el coeficiente de publicidad y reporta con orgullo un efecto "altamente significativo". El consejo de administración aprueba un aumento del presupuesto del 30 % y, al año siguiente, las ventas decepcionan. ¿Qué ha fallado? Muy a menudo, la respuesta es **autocorrelación**: los errores en el trimestre $t$ están correlacionados con los errores en $t-1$, los errores estándar de MCO son demasiado pequeños y el estadístico $t$ está inflado. Este capítulo trata precisamente de cómo diagnosticar y corregir ese problema.
## Contexto: del corte transversal a la serie temporal
`\lettrine[lines=3]{E}{n}`{=latex} los capítulos 1-7 cada observación era un **individuo** (un trabajador, una empresa, un hogar, una provincia) muestreado en un único momento del tiempo. Indexábamos las observaciones por $i = 1,\dots,n$. Las series temporales son distintas: hay una sola unidad —un país, una empresa, un mercado— observada repetidamente a lo largo de períodos discretos. Sustituimos el índice $i$ por $t = 1,\dots,n$ y el modelo poblacional se convierte en
$$
y_t = \beta_0 + \beta_1 x_{1t} + \beta_2 x_{2t} + \cdots + \beta_k x_{kt} + u_t.
$$
En forma matricial, $\mathbf{Y} = \mathbf{X}\beta + \mathbf{u}$, exactamente como antes —solo cambia el índice—. Un ejemplo típico es una serie mensual de datos de una empresa:
| Mes | Ventas $y_t$ | Publicidad $x_t$ |
|------------|--------------|------------------|
| Ene 2020 | 120 | 15 |
| Feb 2020 | 135 | 18 |
| Mar 2020 | 128 | 10 |
| $\vdots$ | $\vdots$ | $\vdots$ |
| Nov 2020 | 175 | 24 |
| Dic 2020 | 190 | 30 |
Desde el punto de vista mecánico, casi todo lo aprendido en los capítulos 2-6 se traslada sin cambios: MCO sigue resolviendo $\min_{\beta} \sum_t (y_t - \mathbf{x}_t'\beta)^2$; la interpretación por partialling-out es la misma; los regresores no lineales y cualitativos se comportan igual. Lo que cambia es la **estructura del error**. Dos errores $u_t$ y $u_s$ se refieren a la *misma* unidad económica observada en *momentos distintos*, y en general no hay razón para que sean incorrelados.
::: {.callout-note}
## Recordatorio del supuesto RLM.2 (muestra aleatoria) en contexto temporal
El supuesto RLM.2 en datos de corte transversal exigía que la muestra constara de $n$ extracciones *independientes*: para todo par $i\neq j$, $\mathbb{E}[u_i\,u_j]=0$. El mecanismo que garantizaba RLM.2 era el muestreo aleatorio de una población fija: conocer $u_i$ no aportaba información sobre $u_j$.
En una serie temporal no hay muestreo aleatorio entre unidades. Los errores sucesivos $u_t$ y $u_{t+1}$ son generados por el *mismo* proceso que se despliega en el tiempo, y lo natural es que estén relacionados. Cuando $\mathbb{E}[u_t\,u_s] \neq 0$ para algún $t\neq s$ decimos que los errores están **autocorrelacionados** (o presentan **correlación serial**). ¿Influirá el shock no observado de demanda de enero sobre febrero? Casi con seguridad, sí —y esa es la definición operativa de autocorrelación.
:::
El contraste con el capítulo 7 es útil. La **heterocedasticidad** es una patología transversal en la que $\operatorname{Var}(u_i)$ depende de los regresores, pero los errores entre unidades son independientes. La **autocorrelación** es su prima temporal: los elementos *fuera de la diagonal* de la matriz de varianzas-covarianzas del error son no nulos, mientras que la diagonal puede o no permanecer constante. Ambas dejan a MCO insesgado, pero invalidan sus errores estándar.
## Definición, estructura AR(1) y consecuencias
### Definición
::: {.callout-note}
## Definición (autocorrelación)
Diremos que las perturbaciones $u_t$ presentan **autocorrelación** (o **correlación serial**) cuando
$$
\operatorname{Cov}(u_t, u_s) \neq 0 \quad \text{para algún } t \neq s.
$$
La matriz de varianzas-covarianzas del vector $\mathbf{u} = (u_1,\dots,u_n)'$ es entonces
$$
\operatorname{Var}(\mathbf{u}) =
\begin{pmatrix}
\sigma^2 & \gamma_1 & \gamma_2 & \cdots & \gamma_{n-1} \\
\gamma_1 & \sigma^2 & \gamma_1 & \cdots & \gamma_{n-2} \\
\gamma_2 & \gamma_1 & \sigma^2 & \cdots & \gamma_{n-3} \\
\vdots & \vdots & \vdots & \ddots & \vdots \\
\gamma_{n-1} & \gamma_{n-2} & \gamma_{n-3} & \cdots & \sigma^2
\end{pmatrix},
$$
con al menos un elemento fuera de la diagonal $\gamma_k = \operatorname{Cov}(u_t, u_{t-k}) \neq 0$.
:::
Bajo los supuestos clásicos del modelo de regresión lineal con datos transversales, los elementos fuera de la diagonal son todos nulos y $\operatorname{Var}(\mathbf{u}) = \sigma^2 \mathbf{I}_n$. La autocorrelación rompe esa simplificación.
### El modelo AR(1): el caballo de batalla
A lo largo de todo el capítulo —y de la inmensa mayoría del trabajo aplicado de grado— utilizaremos un modelo concreto para la dependencia serial: el proceso **autorregresivo de primer orden** o **AR(1)**:
$$
u_t = \rho\,u_{t-1} + \varepsilon_t, \qquad |\rho| < 1,
$$
donde $\varepsilon_t$ es un **ruido blanco**: $\mathbb{E}[\varepsilon_t]=0$, $\operatorname{Var}(\varepsilon_t) = \sigma_\varepsilon^2$ constante, $\operatorname{Cov}(\varepsilon_t,\varepsilon_s)=0$ para $t \neq s$ y (habitualmente) $\varepsilon_t \sim \mathcal{N}(0,\sigma_\varepsilon^2)$. La condición $|\rho|<1$ garantiza la **estacionariedad** del proceso, es decir, que su media, varianza y autocovarianzas no dependan del tiempo.
Un único parámetro $\rho$ resume toda la estructura de dependencia. Bajo estacionariedad puede demostrarse:
$$
\mathbb{E}[u_t] = 0, \qquad
\operatorname{Var}(u_t) = \frac{\sigma_\varepsilon^2}{1-\rho^2}, \qquad
\operatorname{Cov}(u_t, u_{t-k}) = \rho^k \cdot \frac{\sigma_\varepsilon^2}{1-\rho^2}.
$$
De modo que $\gamma_k = \rho^k \sigma^2$ con $\sigma^2 = \sigma_\varepsilon^2/(1-\rho^2)$: las autocovarianzas **decaen geométricamente** en el retardo $k$. El signo de $\rho$ clasifica el patrón:
- **$\rho > 0$ (autocorrelación positiva).** Los errores del mismo signo se agrupan. Un shock positivo persiste, y se atenúa suavemente: largas rachas de residuos positivos, seguidas de largas rachas de residuos negativos. Es con diferencia el caso más frecuente en datos macroeconómicos y empresariales.
- **$\rho < 0$ (autocorrelación negativa).** Los errores alternan en signo: cada shock positivo es seguido, con probabilidad desproporcionada, por uno negativo. Menos habitual, pero aparece en series de inventarios y en modelos donde el ajuste sobrerreacciona.
- **$\rho = 0$ (sin autocorrelación).** $u_t = \varepsilon_t$ y los errores son ruido blanco: se recupera el caso transversal por defecto.
Los procesos de orden superior (AR(2), AR($p$), ARMA, …) existen y se estudian en Econometría II; para nuestros propósitos el AR(1) basta para fijar las ideas y motivar los diagnósticos y correcciones que siguen.
### Consecuencias para MCO
¿Qué efecto tiene la autocorrelación sobre el estimador MCO $\hat{\beta}$?
1. **MCO sigue siendo insesgado y consistente** —siempre que la esperanza condicional esté correctamente especificada, esto es, $\mathbb{E}[u_t \mid \mathbf{x}_t] = 0$—. La autocorrelación afecta a los elementos *fuera de la diagonal* de $\operatorname{Var}(\mathbf{u})$ y no desplaza la media del estimador respecto a $\beta$. Las estimaciones puntuales no son el problema.
2. **MCO ya no es ELIO (BLUE).** Pierde la propiedad de óptimalidad: ya no es el estimador lineal e insesgado de mínima varianza. Existe un estimador alternativo, el de **Mínimos Cuadrados Generalizados (MCG)**, que sí lo es (§8.4).
3. **Los errores estándar habituales de MCO son incorrectos.** La fórmula de manual $\operatorname{Var}(\hat{\beta}) = \sigma^2 (\mathbf{X}'\mathbf{X})^{-1}$ presupone $\operatorname{Var}(\mathbf{u}) = \sigma^2 \mathbf{I}_n$, supuesto que falla. Bajo autocorrelación **positiva**, los errores estándar reportados por MCO típicamente *infravaloran* la variabilidad muestral verdadera: los estadísticos $t$ resultan demasiado grandes, los $p$-valores demasiado pequeños y los intervalos de confianza demasiado estrechos. Los "estadísticos $t$ optimistas" de la pregunta motivadora son exactamente este artefacto.
::: {.callout-warning}
## Causalidad frente a eficiencia: la trampa del retardo de la variable dependiente
Existe un caso en el que la autocorrelación va más allá de inflar los $t$: destruye la identificación. Si la regresión incluye un **retardo de la variable dependiente** $y_{t-1}$ y los errores son AR(1),
$$
y_t = \alpha\,y_{t-1} + \beta_0 + \beta_1 x_t + u_t, \qquad u_t = \rho\,u_{t-1} + \varepsilon_t,
$$
entonces $y_{t-1}$ depende de $u_{t-1}$, y $u_{t-1}$ está correlacionado con $u_t$ a través de $\rho$. El regresor queda correlacionado con el error, $\mathbb{E}[u_t \mid y_{t-1}] \neq 0$, y MCO ya no es solo ineficiente: se vuelve **sesgado e inconsistente**. El coeficiente causal $\beta_1$ deja de estar identificado. Es el primo temporal del sesgo de variable omitida del capítulo 3.
:::
La intuición de por qué la autocorrelación positiva hace que los errores estándar de MCO sean demasiado pequeños merece reflexión: si los errores sucesivos contienen información sobre los siguientes, $n$ observaciones correlacionadas aportan *menos información independiente* que $n$ observaciones incorreladas. El **tamaño muestral efectivo** es menor que el nominal $n$, pero la fórmula de MCO trata cada observación como si fuese una extracción fresca. La precisión reportada está, por tanto, exagerada.
## Detección
Disponemos de dos cajas de herramientas complementarias: **gráfica** (rápida e intuitiva) y **analítica** (contrastes formales). El flujo de trabajo recomendado es mirar primero y contrastar después.
### Métodos gráficos
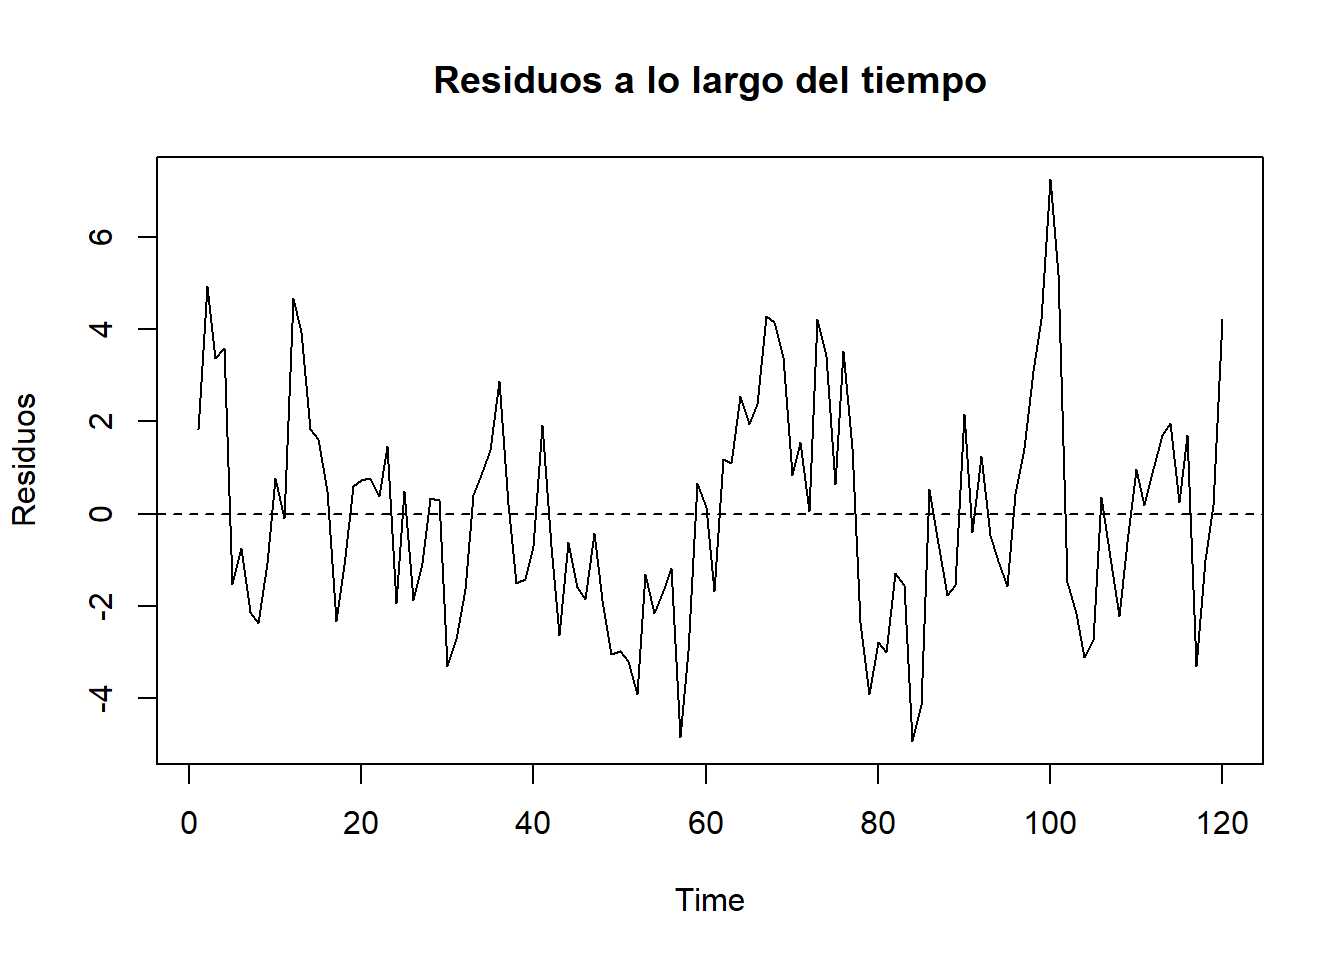
**Gráfico temporal de los residuos.** Representamos $\hat u_t$ frente a $t$. Si los errores están incorrelados, los residuos deberían dispersarse aleatoriamente alrededor de cero —sin patrón visible, sin agrupamientos, sin ciclos manifiestos—. Si observamos **rachas largas** de residuos del mismo signo (muchos positivos consecutivos, luego muchos negativos), esa es la firma visual de $\rho>0$. Si los residuos alternan en un patrón de diente de sierra, indica $\rho<0$.
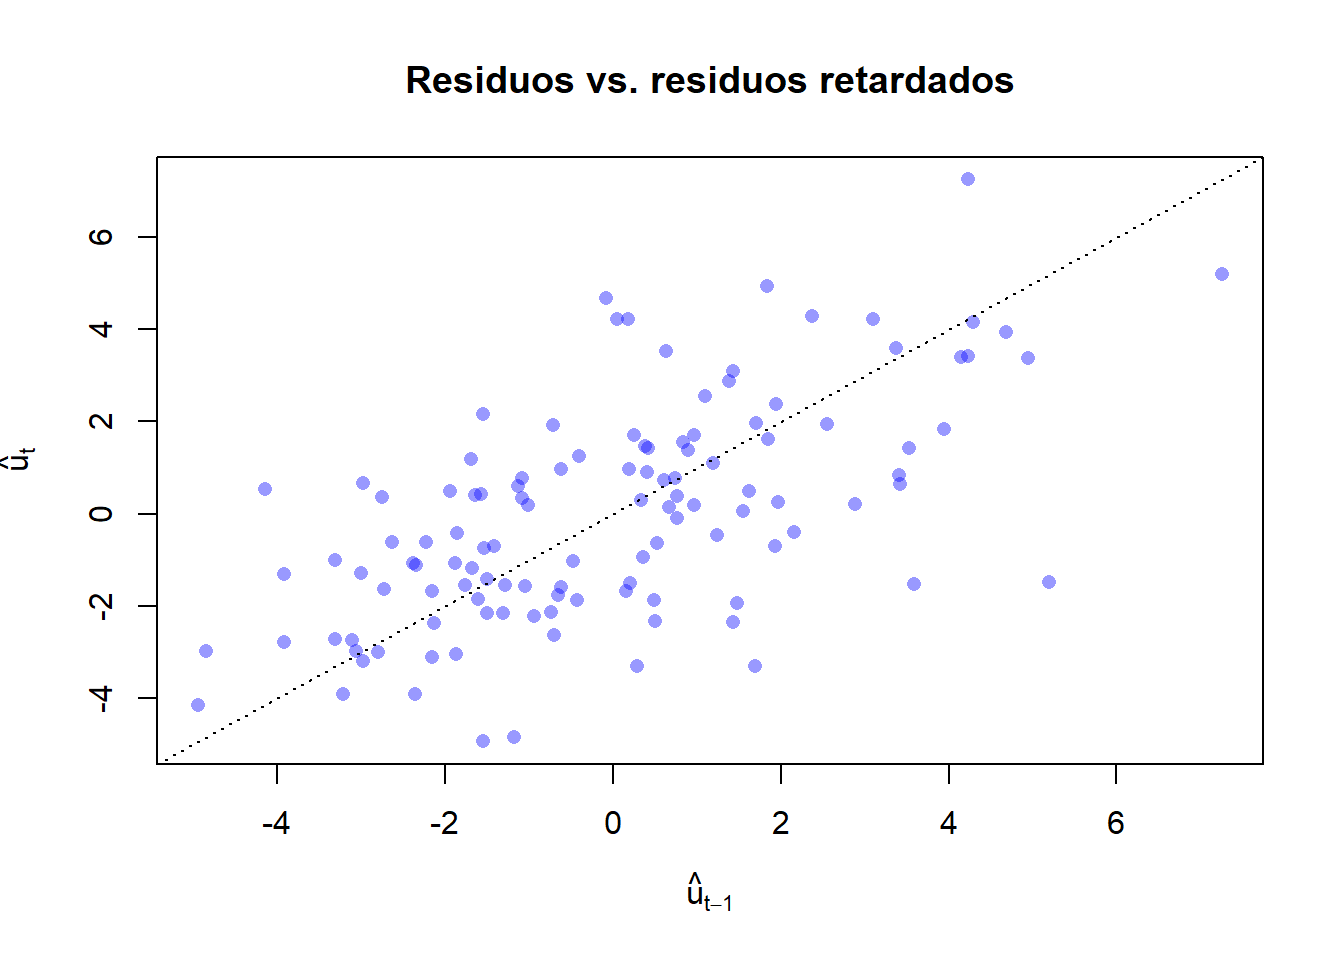
**Gráfico de retardos.** Representamos $\hat u_t$ en el eje vertical frente a $\hat u_{t-1}$ en el horizontal. Bajo $\rho=0$ la nube no tiene pendiente; bajo $\rho>0$ se inclina hacia arriba a la derecha (asociación lineal positiva); bajo $\rho<0$ se inclina hacia abajo. Mecánicamente, esta es la imagen de la regresión MCO $\hat u_t = \rho\,\hat u_{t-1} + \text{(ruido)}$, cuya pendiente es exactamente el estimador de $\rho$ que utilizaremos a continuación.
Las tres formas de referencia son: una nube sin estructura ($\rho\approx 0$), una recta de pendiente positiva ($\rho>0$) y una recta de pendiente negativa ($\rho<0$). En la práctica del §8.5 veremos las tres.
### El contraste de Durbin-Watson
El estadístico de **Durbin-Watson (DW)** es el contraste formal por excelencia para la autocorrelación de primer orden.
::: {.callout-note}
## Definición (estadístico de Durbin-Watson)
$$
DW = \frac{\sum_{t=2}^{n} (\hat u_t - \hat u_{t-1})^2}{\sum_{t=1}^{n} \hat u_t^2}.
$$
El contraste es de $H_0: \rho = 0$ (incorrelación) frente a $H_1: \rho \neq 0$ (autocorrelación), o bien frente a una alternativa unilateral.
:::
**Por qué $DW \approx 2(1-\hat\rho)$.** Desarrollamos el cuadrado del numerador:
$$
\sum_{t=2}^{n}(\hat u_t - \hat u_{t-1})^2
= \sum_{t=2}^{n} \hat u_t^2 \;-\; 2\sum_{t=2}^{n}\hat u_t \hat u_{t-1} \;+\; \sum_{t=2}^{n} \hat u_{t-1}^2.
$$
Si la muestra es suficientemente grande, $\sum_{t=2}^{n}\hat u_t^2 \simeq \sum_{t=2}^{n} \hat u_{t-1}^2 \simeq \sum_{t=1}^{n}\hat u_t^2$ (las tres sumas difieren a lo sumo en una observación). Dividiendo:
$$
DW \;\approx\; \frac{2\sum_{t=2}^{n}\hat u_t^2 - 2\sum_{t=2}^{n} \hat u_t \hat u_{t-1}}{\sum_{t=1}^{n}\hat u_t^2}
\;=\; 2\left(1 - \frac{\sum_{t=2}^{n} \hat u_t \hat u_{t-1}}{\sum_{t=1}^{n}\hat u_t^2}\right)
\;=\; 2(1 - \hat\rho),
$$
donde $\hat\rho = \sum_{t=2}^n \hat u_t \hat u_{t-1} \big/ \sum_{t=1}^n \hat u_t^2$ es la autocorrelación muestral de primer orden de los residuos. Puesto que $\rho \in [-1,1]$, el estadístico vive en el intervalo $[0,4]$:
- $DW \simeq 0 \;\Leftrightarrow\; \hat\rho \simeq +1$ (autocorrelación positiva fuerte).
- $DW \simeq 2 \;\Leftrightarrow\; \hat\rho \simeq 0$ (incorrelación).
- $DW \simeq 4 \;\Leftrightarrow\; \hat\rho \simeq -1$ (autocorrelación negativa fuerte).
**Cotas y regla de decisión.** La distribución exacta de $DW$ depende de la matriz de diseño $\mathbf{X}$, de modo que Durbin y Watson tabularon una **cota inferior** $d_L$ y una **cota superior** $d_U$ (funciones de $n$, del número de regresores $k$ y del nivel de significación). La regla de decisión, para el contraste con alternativa unilateral $H_1:\rho>0$, es:
| Región | Conclusión |
|---------------------------------|-------------------------------------------------------|
| $0 < DW < d_L$ | Se rechaza $H_0$: autocorrelación **positiva**. |
| $d_L < DW < d_U$ | **Zona de indeterminación.** |
| $d_U < DW < 4 - d_U$ | No se rechaza $H_0$: incorrelación. |
| $4 - d_U < DW < 4 - d_L$ | **Zona de indeterminación.** |
| $4 - d_L < DW < 4$ | Se rechaza $H_0$: autocorrelación **negativa**. |
Las dos zonas de indeterminación son inevitables: son el precio que se paga por no tener que asumir una matriz de diseño concreta. En software moderno (`lmtest::dwtest()` en R, por ejemplo), el contraste devuelve un $p$-valor exacto calculado para la $\mathbf{X}$ observada, evitando el manejo de tablas. Las cotas se utilizan en ejercicios a mano; el $p$-valor, en el laboratorio.
::: {.callout-tip}
## Ejemplo resuelto: cálculo manual de DW (accidentes y coches)
Una ciudad registra durante 10 años el número de pequeños accidentes $Y_t$ y el número de coches matriculados $X_t$:
| $Y$ | 25 | 27 | 28 | 32 | 33 | 36 | 38 | 40 | 41 | 45 |
|-----|-----|-----|-----|-----|-----|-----|-----|-----|-----|-----|
| $X$ | 510 | 520 | 528 | 540 | 590 | 650 | 700 | 760 | 800 | 870 |
La estimación MCO del modelo $Y_t = \beta_1 + \beta_2 X_t + u_t$ es
$$\hat Y_t = 2{,}5676 + 0{,}04937\,X_t,\qquad R^2 = 0{,}942.$$
Construimos la tabla de residuos y sus diferencias:
| $Y$ | $\hat Y$ | $\hat u_t$ | $\hat u_{t-1}$ | $(\hat u_t - \hat u_{t-1})^2$ | $\hat u_t^2$ |
|-----|-----------|------------|----------------|-------------------------------|--------------|
| 25 | 27{,}7462 | $-2{,}7462$ | — | — | 7{,}5416 |
| 27 | 28{,}2399 | $-1{,}2399$ | $-2{,}7462$ | 2{,}2689 | 1{,}5374 |
| 28 | 28{,}6349 | $-0{,}6349$ | $-1{,}2399$ | 0{,}3661 | 0{,}4030 |
| 32 | 29{,}2273 | $\phantom{-}2{,}7727$ | $-0{,}6349$ | 11{,}6115 | 7{,}6879 |
| 33 | 31{,}6958 | $\phantom{-}1{,}3042$ | $\phantom{-}2{,}7727$ | 2{,}1565 | 1{,}7010 |
| 36 | 34{,}6580 | $\phantom{-}1{,}3420$ | $\phantom{-}1{,}3042$ | 0{,}0014 | 1{,}8010 |
| 38 | 37{,}1265 | $\phantom{-}0{,}8735$ | $\phantom{-}1{,}3420$ | 0{,}2195 | 0{,}7630 |
| 40 | 40{,}0887 | $-0{,}0887$ | $\phantom{-}0{,}8735$ | 0{,}9258 | 0{,}0079 |
| 41 | 42{,}0635 | $-1{,}0635$ | $-0{,}0887$ | 0{,}9502 | 1{,}1310 |
| 45 | 45{,}5194 | $-0{,}5194$ | $-1{,}0635$ | 0{,}2961 | 0{,}2697 |
| | | | | **18{,}7960** | **22{,}8435** |
El estadístico vale
$$DW = \frac{18{,}7960}{22{,}8435} \approx 0{,}823.$$
Para $n=10$ y $k=1$, las cotas al 5 % son $d_L=0{,}879$ y $d_U=1{,}320$. Como $DW < d_L$, **se rechaza** $H_0$ y se concluye que existe autocorrelación positiva. Usaremos este mismo ejemplo en §8.4 para ilustrar Cochrane-Orcutt.
:::
### Cuando DW falla: el h-test de Durbin
El contraste de DW descansa sobre dos hipótesis que a menudo quedan implícitas: el proceso del error es AR(1) y la regresión **no** incluye un retardo de la variable dependiente. El caso del retardo —discutido en el recuadro de advertencia del §8.2.3— es precisamente aquel en el que MCO se vuelve inconsistente, y en el que DW pasa a estar fuertemente sesgado hacia 2 (hacia la hipótesis nula de no autocorrelación), que es el peor comportamiento posible para un contraste diagnóstico.
Para modelos de la forma
$$
y_t = \alpha\,y_{t-1} + \beta_0 + \beta_1 x_{1t} + \cdots + \beta_k x_{kt} + u_t, \qquad u_t = \rho\,u_{t-1} + \varepsilon_t,
$$
Durbin propuso el **estadístico $h$**:
$$
h \;=\; \hat\rho \,\sqrt{\frac{n}{1 - n\,\widehat{\operatorname{Var}}(\hat\alpha)}} \;\sim\; \mathcal{N}(0,1) \quad \text{bajo } H_0:\rho=0,
$$
donde $\hat\alpha$ es el coeficiente MCO sobre $y_{t-1}$ y $\widehat{\operatorname{Var}}(\hat\alpha)$ es la varianza MCO habitual (la "incorrecta"). Suele utilizarse $\hat\rho \approx 1 - DW/2$. Se rechaza $H_0$ al nivel $\alpha$ si $|h| > z_{1-\alpha/2}$.
::: {.callout-tip}
## Ejemplo resuelto: h-test de Durbin
Sea la estimación MCO con $n=21$ observaciones:
$$\widehat Y_t = 1{,}3 + 0{,}97\,Y_{t-1} + 2{,}31\,X_t, \qquad \mathrm{se}(\hat\alpha) = 0{,}07, \qquad DW = 1{,}21.$$
Entonces $\hat\rho \approx 1 - 1{,}21/2 = 0{,}395$, $\widehat{\operatorname{Var}}(\hat\alpha) = 0{,}07^2 = 0{,}0049$ y
$$h = 0{,}395 \cdot \sqrt{\frac{21}{1 - 21 \cdot 0{,}0049}} = 0{,}395 \cdot 4{,}838 \approx 1{,}91.$$
Al 5 % el valor crítico es $z_{0{,}975}=1{,}96$. Como $|h|=1{,}91 < 1{,}96$, **no se rechaza** $H_0$: no hay evidencia estadística de autocorrelación de primer orden. Una lectura ingenua del DW de $1{,}21$ podría haber sugerido lo contrario, pero DW está sesgado en este modelo.
:::
Existen otros contrastes —la prueba LM de **Breusch-Godfrey**, válida para órdenes superiores; la prueba portmanteau de **Ljung-Box**— que se cubren en Econometría II. Para esta asignatura, DW (o el $h$ de Durbin cuando proceda) es la herramienta estándar.
## Corrección: de MCG a Cochrane-Orcutt
Si MCO es ineficiente bajo AR(1), ¿qué debemos hacer? La respuesta es **Mínimos Cuadrados Generalizados (MCG)**: transformar el modelo de modo que los errores transformados sean ruido blanco, y entonces aplicar MCO al modelo transformado.
### La cuasi-diferenciación de MCG
Partimos del modelo y de su retardo multiplicado por $\rho$:
$$
y_t = \beta_0 + \beta_1 x_t + u_t, \qquad \rho\,y_{t-1} = \rho\beta_0 + \rho\beta_1 x_{t-1} + \rho\,u_{t-1}.
$$
Restando la segunda ecuación de la primera:
$$
y_t - \rho\,y_{t-1} = \beta_0(1-\rho) + \beta_1(x_t - \rho\,x_{t-1}) + (u_t - \rho\,u_{t-1}).
$$
Por el supuesto AR(1), $u_t - \rho\,u_{t-1} = \varepsilon_t$, que es ruido blanco. Definimos las variables **cuasi-diferenciadas**:
$$
y_t^* \;=\; y_t - \rho\,y_{t-1}, \qquad
x_t^* \;=\; x_t - \rho\,x_{t-1}, \qquad
\beta_0^{*} \;=\; \beta_0(1-\rho).
$$
La regresión transformada
$$
y_t^* = \beta_0^* + \beta_1\,x_t^* + \varepsilon_t
$$
tiene errores homocedásticos e incorrelados —se recuperan los supuestos clásicos del modelo de regresión—, y MCO sobre el modelo transformado es el **estimador MCG**, que es óptimo (BLUE).
**La primera observación.** La transformación tal como está escrita pierde la observación $t=1$. Para conservarla, la **modificación de Prais-Winsten** la reescala de modo distinto:
$$
y_1^* = \sqrt{1-\rho^2}\,y_1, \qquad x_1^* = \sqrt{1-\rho^2}\,x_1, \qquad \text{cte}_1^* = \sqrt{1-\rho^2}.
$$
El factor $\sqrt{1-\rho^2}$ es justamente el que hace que $\operatorname{Var}(u_1^*) = \sigma_\varepsilon^2$, igualándola al resto. En muestras pequeñas esto importa; en muestras grandes, descartar la observación 1 ("Cochrane-Orcutt en dos etapas") es prácticamente equivalente.
En forma matricial, la transformación MCG se escribe de forma compacta como
$$
\mathbf{Y}^* \;=\;
\begin{pmatrix}
\sqrt{1-\rho^2}\,y_1 \\
y_2 - \rho\,y_1 \\
\vdots \\
y_n - \rho\,y_{n-1}
\end{pmatrix},
\qquad
\mathbf{X}^* \;=\;
\begin{pmatrix}
\sqrt{1-\rho^2} & \sqrt{1-\rho^2}\,x_{21} & \cdots & \sqrt{1-\rho^2}\,x_{k1} \\
1-\rho & x_{22} - \rho\,x_{21} & \cdots & x_{k2} - \rho\,x_{k1} \\
\vdots & \vdots & \ddots & \vdots \\
1-\rho & x_{2n} - \rho\,x_{2,n-1} & \cdots & x_{kn} - \rho\,x_{k,n-1}
\end{pmatrix}.
$$
Aplicando MCO a $(\mathbf{Y}^*, \mathbf{X}^*)$ se obtiene $\hat{\beta}_{\text{MCG}}$.
### El procedimiento iterativo de Cochrane-Orcutt
La pega: $\rho$ es desconocido. Hay que estimarlo. El procedimiento de **Cochrane-Orcutt (CO)** es el algoritmo de MCG factibles más sencillo: alternar entre estimar $\rho$ a partir de los residuos y reestimar $\beta$ sobre los datos cuasi-diferenciados, hasta que $\rho$ se estabilice.
::: {.callout-note}
## Algoritmo: procedimiento iterativo de Cochrane-Orcutt
1. Estimar el modelo original $y_t = \beta_0 + \beta_1 x_t + \cdots + u_t$ por MCO y obtener los residuos $\hat u_t$.
2. Estimar $\rho$ regresando $\hat u_t$ sobre $\hat u_{t-1}$ (sin término constante):
$$\hat\rho = \frac{\sum_{t=2}^{n}\hat u_t\,\hat u_{t-1}}{\sum_{t=2}^{n}\hat u_{t-1}^2}.$$
3. Construir las variables cuasi-diferenciadas $y_t^* = y_t - \hat\rho\,y_{t-1}$ y $x_t^* = x_t - \hat\rho\,x_{t-1}$ (y, en la variante Prais-Winsten, la primera observación reescalada por $\sqrt{1-\hat\rho^2}$).
4. Aplicar MCO sobre $(y_t^*, x_t^*)$ para obtener nuevos coeficientes $\hat{\beta}^{(2)}$ y nuevos residuos $\hat u_t^{(2)}$.
5. Volver al paso 2 con $\hat u_t^{(2)}$ y actualizar $\hat\rho$.
6. Iterar hasta que $\hat\rho$ converja (la variación entre iteraciones sea despreciable).
El vector final de coeficientes es la estimación MCG factible de Cochrane-Orcutt; los errores estándar reportados son los de MCO en la *regresión transformada*, que son válidos bajo AR(1).
:::
Existen alternativas —el procedimiento CO en dos etapas (una sola iteración), la búsqueda en rejilla de Hildreth-Lu sobre $\rho$, el método de Durbin en dos etapas, Prais-Winsten con mínimos cuadrados restringidos— pero todas comparten la misma idea de fondo: estimar $\rho$, cuasi-diferenciar y aplicar MCO para recuperar un estimador eficiente.
::: {.callout-tip}
## Ejemplo resuelto: Cochrane-Orcutt sobre los datos de accidentes
Retomamos el ejemplo accidentes-vs-coches del §8.3.2. Como $DW = 0{,}823$ y $n=10$ es pequeño, aplicamos la variante de Prais-Winsten.
**Paso 1** (MCO): $\hat Y_t = 2{,}568 + 0{,}0494\,X_t$.
**Paso 2** ($\hat\rho$ a partir de los residuos): la regresión $\hat u_t = \rho\,\hat u_{t-1} + \varepsilon_t$ da
$$\hat\rho = \frac{\sum \hat u_t \hat u_{t-1}}{\sum \hat u_{t-1}^2} = 0{,}4226.$$
**Paso 3** (transformación). Para $t > 1$:
$$Y_t^* = Y_t - 0{,}4226\,Y_{t-1}, \qquad X_t^* = X_t - 0{,}4226\,X_{t-1};$$
y para $t=1$, multiplicamos por $\sqrt{1 - 0{,}4226^2} \approx 0{,}9063$. La tabla resultante es:
| $Y^*$ | cte$^*$ | $X^*$ |
|----------|----------|-----------|
| 22{,}659 | 0{,}9063 | 462{,}220 |
| 16{,}435 | 0{,}5774 | 304{,}471 |
| 16{,}590 | 0{,}5774 | 308{,}245 |
| 20{,}167 | 0{,}5774 | 316{,}864 |
| 19{,}477 | 0{,}5774 | 361{,}793 |
| 22{,}054 | 0{,}5774 | 400{,}662 |
| 22{,}786 | 0{,}5774 | 425{,}306 |
| 23{,}941 | 0{,}5774 | 464{,}176 |
| 24{,}096 | 0{,}5774 | 478{,}819 |
| 27{,}673 | 0{,}5774 | 531{,}915 |
**Paso 4** (MCO sobre las variables transformadas): $\hat Y_t^* = 2{,}111 + 0{,}0498\,X_t^*$.
La pendiente apenas se mueve —MCO era insesgado desde el principio—, pero el nuevo $DW$ sobre los residuos transformados es $1{,}52$, holgadamente dentro de la región de no autocorrelación. Los errores estándar del paso 4 son los válidos.
**Nota.** Como $\hat\rho$ es una estimación, en principio deberíamos iterar el procedimiento hasta convergencia. En la práctica, con esta muestra tan pequeña una sola iteración ya elimina el problema.
:::
La moraleja: en el mundo AR(1), MCO entrega las estimaciones *puntuales* correctas (en promedio), pero con una *incertidumbre* equivocada; Cochrane-Orcutt arregla la incertidumbre sin alterar apenas el punto.
## Práctica: Autocorrelación en R
La práctica sigue el flujo del Tutorial 9 (`autocorr_datos.xlsx`): regresamos ventas trimestrales sobre publicidad y una tendencia temporal, diagnosticamos autocorrelación visual y formalmente con Durbin-Watson, y corregimos con Cochrane-Orcutt. Para que el capítulo sea autocontenido y reproducible sin necesidad del fichero `.xlsx` externo, generamos una versión sintética del tutorial con la misma estructura (ventas dependientes de publicidad más una tendencia, errores AR(1) con $\rho$ conocido). El tutorial interactivo `LEARNR/08_autocorrelation.Rmd` utiliza la misma simulación.
```{r ch08-setup}
#| message: false
library(lmtest)
library(orcutt)

set.seed(2026)
n            <- 120                                    # ~30 años trimestrales
tiempo       <- 1:n
publicidad   <- 5 + 0.5 * tiempo + rnorm(n, 0, 3)      # gasto en publicidad
rho_true     <- 0.7                                    # parámetro AR(1)
u            <- numeric(n); u[1] <- rnorm(1, 0, 2)
for (t in 2:n) u[t] <- rho_true * u[t-1] + rnorm(1, 0, 2)
ventas       <- 10 + 0.8 * publicidad + 0.3 * tiempo + u
autocorr_demo <- data.frame(tiempo = tiempo,
                            publicidad = publicidad,
                            ventas = ventas)
head(autocorr_demo)
```
El proceso generador de datos tiene pendiente `0.8` sobre publicidad, coeficiente de tendencia `0.3` y errores AR(1) con $\rho = 0{,}7$ (autocorrelación positiva fuerte). Un analista real no conocería ninguno de estos valores.
### MCO y primer vistazo a los residuos
```{r ch08-ols}
fit <- lm(ventas ~ publicidad + tiempo, data = autocorr_demo)
summary(fit)
```
El coeficiente sobre `publicidad` está en el orden correcto (alrededor de 0,8), la tendencia también (alrededor de 0,3), y los estadísticos $t$ son espectaculares. ¿Son creíbles? Representemos los residuos a lo largo del tiempo:
```{r ch08-residual-time}
#| fig-cap: "Residuos MCO frente al tiempo. Las rachas largas de mismo signo son la firma visual de autocorrelación positiva."
plot(ts(resid(fit)),
     ylab = "Residuos",
     main = "Residuos a lo largo del tiempo")
abline(h = 0, lty = 2)
```
Los residuos trazan excursiones largas y suaves por encima y por debajo de cero: la imagen exacta de $\rho>0$. La comparación con una serie de residuos incorrelados (una nube sin estructura alrededor de cero) hace evidente la diferencia.
### Gráfico de retardos
```{r ch08-lag-plot}
#| fig-cap: "Gráfico de retardos de los residuos MCO: $\\hat u_t$ frente a $\\hat u_{t-1}$. La inclinación positiva confirma autocorrelación positiva de primer orden."
e <- resid(fit)
plot(head(e, -1), tail(e, -1),
     xlab = expression(hat(u)[t-1]),
     ylab = expression(hat(u)[t]),
     main = "Residuos vs. residuos retardados",
     pch  = 16,
     col  = rgb(0, 0, 1, 0.4))
abline(0, 1, lty = 3)
```
La pendiente de la nube es la estimación de $\rho$. Podemos calcularla directamente:
```{r ch08-rho-from-residuals}
e_lag   <- c(NA, head(e, -1))
rho_hat <- coef(lm(e ~ e_lag - 1))[1]
rho_hat
2 * (1 - rho_hat) # aproximación al DW
```
La autocorrelación residual $\hat\rho$ debería estar cerca del verdadero $0{,}7$, y $2(1-\hat\rho)$ aporta una aproximación rápida al valor que devolverá el contraste de Durbin-Watson.
### Durbin-Watson
```{r ch08-dw}
dwtest(fit)
```
El estadístico $DW$ queda bien por debajo de 2, el $p$-valor es minúsculo y rechazamos $H_0: \rho = 0$ a favor de autocorrelación positiva. Compárese $DW$ con $2(1-\hat\rho)$ del chunk anterior: deben coincidir salvo redondeo.
### Corrección de Cochrane-Orcutt
```{r ch08-co}
co <- cochrane.orcutt(fit)
summary(co)
```
`cochrane.orcutt()` itera el algoritmo del §8.4.2 hasta convergencia y muestra los coeficientes corregidos, la $\hat\rho$ iterada y un estadístico DW calculado sobre los residuos transformados.
::: {.callout-note}
## Una nota sobre `cochrane.orcutt()` frente a Prais-Winsten
El álgebra del §8.4.1 derivó una transformación de Prais-Winsten que *reescala* la primera observación por $\sqrt{1 - \rho^2}$ para conservarla. La función `cochrane.orcutt()` del paquete **orcutt** implementa, en cambio, la variante en dos etapas de Cochrane-Orcutt, que *descarta* la primera observación. Con $n = 120$ como en nuestra muestra, ambas son esencialmente equivalentes; en muestras pequeñas el reescalado sí importa y conviene recurrir a `prais::prais_winsten()` para un ajuste de Prais-Winsten propiamente dicho. Aquí nos quedamos con la variante que descarta la primera observación para mantener la coherencia con la descripción algorítmica del §8.4.1.
:::
Comparamos resultados MCO y CO lado a lado:
```{r ch08-compare}
cat("--- Coeficientes MCO ---\n")
print(round(coef(fit), 4))
cat("\n--- Coeficientes Cochrane-Orcutt ---\n")
print(round(co$coefficients, 4))
cat("\nRho estimado:        ", round(co$rho, 4),
    "(rho verdadero = ", rho_true, ")\n")
cat("DW tras la correccion:", round(co$DW[1], 4), "\n")
```
Hay tres observaciones típicas de esta corrección:
1. Las **estimaciones puntuales** de las pendientes apenas cambian. MCO era insesgado: lo único que iba mal era la incertidumbre.
2. Los **errores estándar** en la salida de CO son mayores que los de MCO. Los $t$ de MCO estaban inflados; los corregidos son más honestos. Hipótesis "altamente significativas" pueden quedar meramente significativas, o incluso dejar de rechazar.
3. El $DW$ sobre los residuos transformados está cerca de 2, indicando que la corrección AR(1) ha cumplido su función. Si el nuevo $DW$ siguiera lejos de 2, los residuos podrían seguir un proceso más rico (AR(2), p. ej.), fuera del alcance del capítulo.
### Una Cochrane-Orcutt manual en un paso
Para ver exactamente qué hace `cochrane.orcutt()` por dentro, replicamos el algoritmo manualmente en una sola iteración:
```{r ch08-manual-co}
y  <- autocorr_demo$ventas
x1 <- autocorr_demo$publicidad
x2 <- autocorr_demo$tiempo

# Paso 2: rho a partir de los residuos (ya calculado como rho_hat)
# Paso 3: variables cuasi-diferenciadas
y_q  <- y[-1]  - rho_hat * y[-n]
x1_q <- x1[-1] - rho_hat * x1[-n]
x2_q <- x2[-1] - rho_hat * x2[-n]

# Paso 4: MCO sobre el modelo transformado
fit_q <- lm(y_q ~ x1_q + x2_q)
summary(fit_q)$coefficients
# Recuperar el intercepto en la escala original
beta0_escala_original <- coef(fit_q)["(Intercept)"] / (1 - rho_hat)
beta0_escala_original
dwtest(fit_q) # DW debería estar cerca de 2
```
Una sola iteración ya recoge la mayor parte del beneficio. La función `cochrane.orcutt()` completamente iterada pule $\hat\rho$ hasta convergencia; en la práctica, unas pocas iteraciones bastan.
::: {.callout-warning}
## El problema no es el sesgo, es la incertidumbre
El coeficiente MCO sobre `publicidad` era insesgado, incluso con $\rho=0{,}7$. El problema era que su error estándar era *demasiado pequeño*. Si hubieras tomado el $t$ de MCO al pie de la letra y construido un intervalo de confianza para una predicción, tu intervalo habría infracubierto la verdad: precisamente la advertencia de la pregunta motivadora.
:::
## Auto-evaluación {.unnumbered}
Siete preguntas cortas de elección múltiple. Intenta responder antes de desplegar la respuesta.
::: {.callout-tip collapse="true"}
## P1. ¿Qué es la autocorrelación?
La autocorrelación (correlación serial) significa que:
- A. $\operatorname{Var}(u_t)$ depende de los regresores $x_t$.
- B. $\operatorname{Cov}(u_t, u_s) \neq 0$ para algún $t \neq s$ —los errores están correlacionados entre períodos.
- C. $x_t$ está correlacionado con $u_t$.
- D. $\mathbb{E}[u_t] \neq 0$.
**Respuesta: B.** La autocorrelación es una propiedad de los elementos *fuera de la diagonal* de la matriz de varianzas-covarianzas del error. (A) es heterocedasticidad, (C) es endogeneidad, (D) es violación de media cero.
:::
::: {.callout-tip collapse="true"}
## P2. Consecuencias para MCO
Bajo errores AR(1) y con $\mathbb{E}[u_t \mid x_t] = 0$, el estimador MCO es:
- A. Siempre sesgado.
- B. Siempre inconsistente.
- C. Aún insesgado y consistente, pero ya no es ELIO (BLUE), y los errores estándar habituales son incorrectos.
- D. Sigue siendo ELIO.
**Respuesta: C.** MCO conserva las propiedades puntuales pero pierde eficiencia y los errores estándar habituales no son válidos. (B) es correcta solo en el caso particular de retardo de la variable dependiente.
:::
::: {.callout-tip collapse="true"}
## P3. El proceso AR(1)
En el modelo $u_t = \rho u_{t-1} + \varepsilon_t$ con $|\rho|<1$ y $\varepsilon_t$ ruido blanco, la autocorrelación es:
- A. Positiva cuando $\rho > 0$, negativa cuando $\rho<0$; las autocovarianzas decaen geométricamente.
- B. Siempre positiva.
- C. Independiente de $\rho$.
- D. Equivalente a la heterocedasticidad.
**Respuesta: A.** El signo de $\rho$ fija el patrón y $\operatorname{Cov}(u_t, u_{t-k}) = \rho^k \sigma^2$ decae geométricamente con el retardo.
:::
::: {.callout-tip collapse="true"}
## P4. Lectura del gráfico temporal de residuos
Un gráfico de residuos MCO contra el tiempo muestra largas rachas de residuos positivos seguidas de largas rachas de residuos negativos. Esto sugiere:
- A. Autocorrelación positiva.
- B. Autocorrelación negativa.
- C. Heterocedasticidad.
- D. Ausencia de patrón sistemático.
**Respuesta: A.** Las rachas persistentes del mismo signo son la firma visual de $\rho>0$. Patrones de diente de sierra (signos alternados) sugieren $\rho<0$.
:::
::: {.callout-tip collapse="true"}
## P5. El estadístico de Durbin-Watson
Para $n$ grande, el estadístico de Durbin-Watson satisface:
- A. $DW = \hat\rho$.
- B. $DW = 1 + \hat\rho$.
- C. $DW \approx 2(1 - \hat\rho)$.
- D. $DW = 2\hat\rho$.
**Respuesta: C.** Desarrollando el cuadrado del numerador y usando $\sum \hat u_t^2 \approx \sum \hat u_{t-1}^2$ para $n$ grande se obtiene $DW \approx 2(1-\hat\rho)$.
:::
::: {.callout-tip collapse="true"}
## P6. Cuándo DW no es válido
El contraste de Durbin-Watson **no** es válido cuando:
- A. Los errores son normales.
- B. La muestra es grande.
- C. Hay muchos regresores.
- D. La regresión incluye un retardo de la variable dependiente.
**Respuesta: D.** Un retardo de la variable dependiente induce correlación entre regresor y error, sesga $DW$ hacia 2 (hacia la nula) y arruina el contraste. Hay que usar la $h$ de Durbin.
:::
::: {.callout-tip collapse="true"}
## P7. Tras Cochrane-Orcutt
Después de una corrección de Cochrane-Orcutt exitosa, el estadístico DW sobre la regresión transformada debería:
- A. Estar próximo a 0.
- B. Estar próximo a 4.
- C. Coincidir con $\hat\rho$.
- D. Estar próximo a 2.
**Respuesta: D.** Una corrección AR(1) exitosa "blanquea" los residuos, de modo que $\hat\rho^*$ sobre el modelo transformado está próximo a 0 y $DW^* \approx 2(1-0) = 2$. Si $DW$ sigue lejos de 2, la hipótesis AR(1) no es la adecuada.
:::
El conjunto completo (doce preguntas, incluyendo ejercicios de simulación) está en `LEARNR/08_autocorrelation.Rmd`.
## Ejercicios {.unnumbered}
**Ejercicio 8.1 ★ — Lectura de un Durbin-Watson.** Una regresión de ventas trimestrales sobre gasto en publicidad y tendencia temporal utiliza $n=80$ trimestres y $k=2$ regresores. La salida de MCO reporta $DW = 0{,}94$. Las cotas relevantes al 5 % son $d_L = 1{,}59$ y $d_U = 1{,}69$. Enuncia tu conclusión y explica qué implica para los estadísticos $t$ de la regresión.
::: {.callout-tip collapse="true"}
## Ver respuesta
Como $0 < DW < d_L$ (es decir, $0{,}94 < 1{,}59$), se rechaza $H_0:\rho=0$ a favor de $H_1:\rho>0$: hay autocorrelación positiva de primer orden. La $\hat\rho$ implícita es $\approx 1 - DW/2 = 0{,}53$. Los errores estándar de MCO son entonces demasiado pequeños, los $t$ estarán inflados, y cualquier coeficiente "significativo" debería re-contrastarse mediante Cochrane-Orcutt o un estimador HAC tipo Newey-West.
:::
**Ejercicio 8.2 ★ — Signo de la autocorrelación a partir del gráfico de retardos.** Un diagrama de dispersión de $\hat u_t$ frente a $\hat u_{t-1}$ presenta una nube con pendiente claramente *negativa*, con la mayoría de los puntos en los cuadrantes superior-izquierdo e inferior-derecho. ¿Cuál es el signo aproximado de $\rho$? ¿Qué valor aproximado tendrá el $DW$?
::: {.callout-tip collapse="true"}
## Ver respuesta
Pendiente negativa $\Rightarrow \hat\rho < 0$: autocorrelación **negativa**. Con (por ejemplo) $\hat\rho \approx -0{,}5$, $DW \approx 2(1 - (-0{,}5)) = 3$, holgadamente por encima de 2.
:::
**Ejercicio 8.3 ★★ — DW a partir de una tabla de residuos.** Con los datos del ejemplo de §8.3.2: $\sum_{t=2}^{n}(\hat u_t - \hat u_{t-1})^2 = 18{,}796$ y $\sum_{t=1}^{n}\hat u_t^2 = 22{,}844$.
(a) Calcula el estadístico $DW$ y el $\hat\rho$ implícito.
(b) Para $n=10$ y $k=1$, las cotas al 5 % son $d_L = 0{,}879$ y $d_U = 1{,}320$. ¿Cuál es tu conclusión?
(c) Explica brevemente por qué las cotas dependen de $n$ y $k$.
::: {.callout-tip collapse="true"}
## Ver respuesta
(a) $DW = 18{,}796/22{,}844 \approx 0{,}823$ y $\hat\rho \approx 1 - DW/2 \approx 0{,}589$. (b) Como $DW < d_L$, se rechaza $H_0$: autocorrelación positiva. (c) La distribución exacta de $DW$ depende de $\mathbf{X}'\mathbf{X}$; Durbin y Watson la acotaron con dos cotas que dependen solo de $(n,k)$, dejando dos zonas de indeterminación.
:::
**Ejercicio 8.4 ★★ — h-test de Durbin.** Una regresión MCO con $n=21$ produce
$$\widehat Y_t = 1{,}3 + 0{,}97\,Y_{t-1} + 2{,}31\,X_t, \qquad \mathrm{se}(\hat\alpha)=0{,}07,\qquad DW = 1{,}21.$$
Calcula el estadístico $h$ de Durbin y decide al 5 % si hay autocorrelación. ¿Por qué $DW$ por sí solo sería engañoso?
::: {.callout-tip collapse="true"}
## Ver respuesta
$\hat\rho \approx 1 - 1{,}21/2 = 0{,}395$; $\widehat{\operatorname{Var}}(\hat\alpha) = 0{,}07^2 = 0{,}0049$;
$$h = 0{,}395 \cdot \sqrt{21/(1 - 21\cdot 0{,}0049)} \approx 1{,}91.$$
Como $z_{0{,}975}=1{,}96$ y $|h|<1{,}96$, **no se rechaza** $H_0$. El DW de $1{,}21$ está sesgado hacia 2 (la nula) por la presencia de $Y_{t-1}$; usarlo sin más habría llevado a falsificar la presencia de autocorrelación.
:::
**Ejercicio 8.5 ★★ — Por qué la autocorrelación positiva subestima los errores estándar (esquema).** En un párrafo, explica —usando la idea de *tamaño muestral efectivo*— por qué la autocorrelación positiva hace que el error estándar habitual de $\hat\beta_1$ en $y_t = \beta_0 + \beta_1 x_t + u_t$ sea demasiado pequeño. No es necesario derivar fórmulas: basta con una intuición basada en el contenido informativo de $n$ observaciones correlacionadas.
*La respuesta completa se proporciona en la Edición del Profesor.*
**Ejercicio 8.6 ★★★ — Cochrane-Orcutt en un paso, a mano.** Una muestra pequeña arroja $\hat\rho = 0{,}4226$ a partir de los residuos MCO de $Y_t = \beta_0 + \beta_1 X_t + u_t$ con $n=10$ observaciones.
(a) Escribe las fórmulas de las variables cuasi-diferenciadas $Y_t^*$, $X_t^*$ y el término constante transformado, *incluyendo* el tratamiento de Prais-Winsten para $t=1$.
(b) Explica por qué el error estándar de $\hat\beta_1$ sobre $(Y_t^*, X_t^*)$ es el que debe reportarse, y no el de MCO sobre la regresión *original*.
(c) Tras la MCO sobre $(Y_t^*, X_t^*)$, el nuevo $DW$ vale $1{,}52$. Con $n=9$, $k=1$, $d_L=0{,}824$ y $d_U=1{,}320$, ¿iterarías de nuevo o pararías?
*La respuesta completa se proporciona en la Edición del Profesor.*